RL学习笔记
1 RL基础
1.1 agent组成
策略(policy)。智能体会用策略来选取下一步的动作。
策略是智能体的动作模型,它决定了智能体的动作。它其实是一个函数,用于把输入的状态变成动作。策略可分为两种:随机性策略和确定性策略。
随机性策略(stochastic policy)就是 ππ 函数,即π(a∣s)=p(at=a∣st=s)π(a∣s)=p(*at*=a∣*st*=s)。输入一个状态 ss,输出一个概率。 这个概率是智能体所有动作的概率,然后对这个概率分布进行采样,可得到智能体将采取的动作。比如可能是有 0.7 的概率往左,0.3 的概率往右,那么通过采样就可以得到智能体将采取的动作。
**确定性策略(deterministic policy)*就是智能体直接采取最有可能的动作,即 a∗=argmaxaπ(a∣s)a∗=aargmaxπ*(a∣s)。
价值函数(value function)。我们用价值函数来对当前状态进行评估。价值函数用于评估智能体进 入某个状态后,可以对后面的奖励带来多大的影响。价值函数值越大,说明智能体进入这个状态越有利。
1️⃣ 状态价值函数 V(s)
👉 关键词:
State Value Function定义:
在状态 s 下,按照某个策略 π,未来能获得的期望总奖励
👉 通俗理解:
- “我现在这个位置值多少钱?”
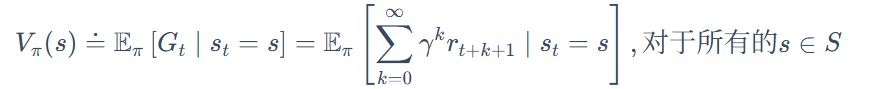
2️⃣ 动作价值函数 Q(s,a)
👉 关键词:
Action Value Function定义:
在状态 s 下,执行动作 a,然后继续按策略 π 行动,能获得的期望总奖励
👉 通俗理解:
“在这个位置,做这个动作值多少钱?”
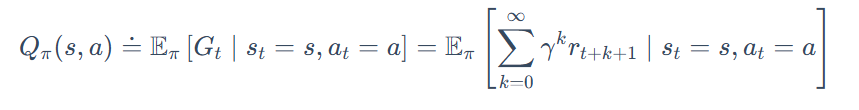
V与Q的相互转换
二者是可以互相转换的:
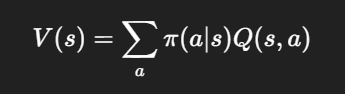
👉 意思是:
- 状态价值 = 所有动作价值的加权平均
模型(model)。模型表示智能体对环境的状态进行理解,它决定了环境中世界的运行方式。
第3个组成部分是模型,模型决定了下一步的状态。下一步的状态取决于当前的状态以及当前采取的动作。它由状态转移概率和奖励函数两个部分组成。状态转移概率即
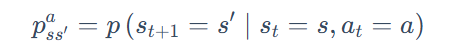
奖励函数是指我们在当前状态采取了某个动作,可以得到多大的奖励,即

1.2马尔科夫决策过程
在随机过程中,马尔可夫性质(Markov property)是指一个随机过程在给定现在状态及所有过去状态情况下,其未来状态的条件概率分布仅依赖于当前状态。以离散随机过程为例,假设随机变量 X0,X1,⋯ ,XTX0,X1,⋯,X**T构成一个随机过程。这些随机变量的所有可能取值的集合被称为状态空间(state space)。如果 Xt+1*Xt*+1 对于过去状态的条件概率分布仅是 Xt*Xt* 的一个函数,则
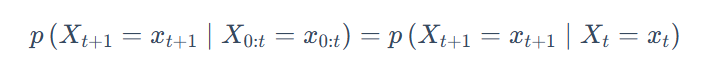
我们可以用状态转移矩阵(state transition matrix)PP 来描述状态转移
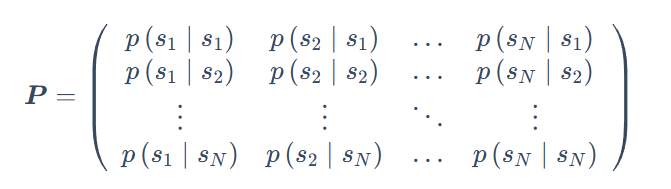
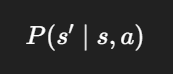
表示:
在状态 s 下执行动作 a,转移到状态 s’ 的概率
1.2.1马尔可夫奖励过程
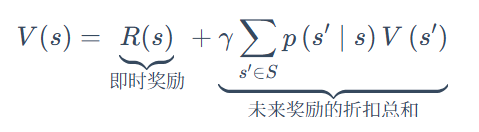
但是这里我们采取了另外一种计算方法,从价值函数里面推导出贝尔曼方程(Bellman equation):
1.2.2马尔可夫决策过程的策略
策略定义了在某一个状态应该采取什么样的动作。知道当前状态后,我们可以把当前状态代入策略函数来得到一个概率,即
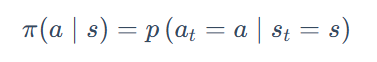
概率代表在所有可能的动作里面怎样采取行动,比如可能有 0.7 的概率往左走,有 0.3 的概率往右走,这是一个概率的表示。另外策略也可能是确定的,它有可能直接输出一个值,或者直接告诉我们当前应该采取什么样的动作,而不是一个动作的概率。假设概率函数是平稳的(stationary),不同时间点,我们采取的动作其实都是在对策略函数进行采样。
已知马尔可夫决策过程和策略 ππ,我们可以把马尔可夫决策过程转换成马尔可夫奖励过程。在马尔可夫决策过程里面,状态转移函数 P(s′∣s,a)P(s′∣s,a) 基于它当前的状态以及它当前的动作。因为我们现在已知策略函数,也就是已知在每一个状态下,可能采取的动作的概率,所以我们就可以直接把动作进行加和,去掉 a,这样我们就可以得到对于马尔可夫奖励过程的转移,这里就没有动作,即
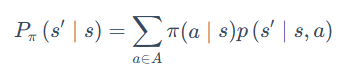
对于奖励函数,我们也可以把动作去掉,这样就会得到类似于马尔可夫奖励过程的奖励函数,即
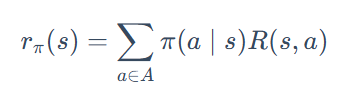
1.2.3马尔可夫决策过程和马尔可夫过程/马尔可夫奖励过程的区别
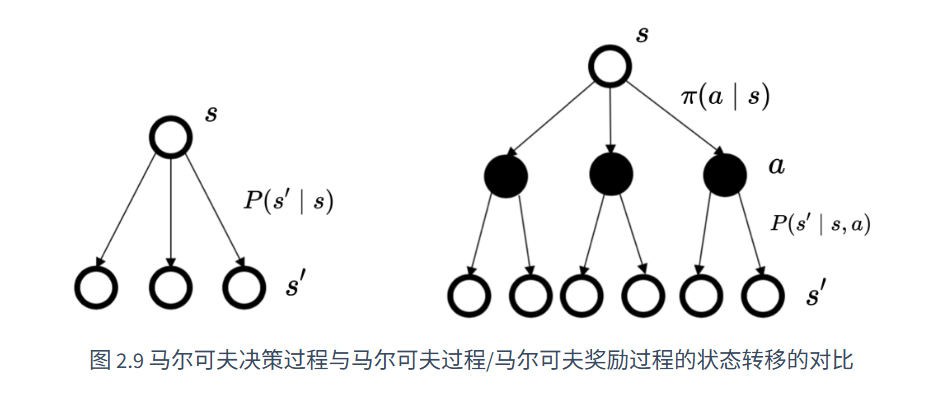
马尔可夫决策过程里面的状态转移与马尔可夫奖励过程以及马尔可夫过程的状态转移的差异如图 2.9 所示。马尔可夫过程/马尔可夫奖励过程的状态转移是直接决定的。比如当前状态是 ss,那么直接通过转移概率决定下一个状态是什么。但对于马尔可夫决策过程,它的中间多了一层动作 aa ,即智能体在当前状态的时候,首先要决定采取某一种动作,这样我们会到达某一个黑色的节点。到达这个黑色的节点后,因为有一定的不确定性,所以当智能体当前状态以及智能体当前采取的动作决定过后,智能体进入未来的状态其实也是一个概率分布。在当前状态与未来状态转移过程中多了一层决策性,这是马尔可夫决策过程与之前的马尔可夫过程/马尔可夫奖励过程很不同的一点。在马尔可夫决策过程中,动作是由智能体决定的,智能体会采取动作来决定未来的状态转移。
1.2.4贝尔曼期望方程
我们可以把状态价值函数和 Q 函数拆解成两个部分:即时奖励和后续状态的折扣价值(discounted value of successor state)。 通过对状态价值函数进行分解,我们就可以得到一个类似于之前马尔可夫奖励过程的贝尔曼方程————贝尔曼期望方程(Bellman expectation equation):
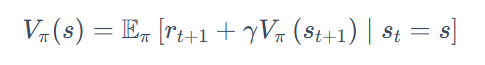
对于 Q 函数,我们也可以做类似的分解,得到 Q 函数的贝尔曼期望方程:
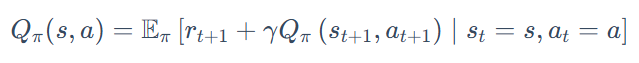
由于:
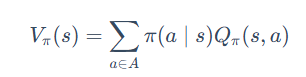
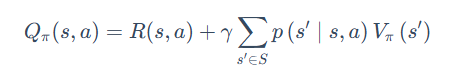
相互代入得:


2 表格方法
2.1 Q-learning
Q学习是一种异策略(off-policy)算法。如图 3.31 所示,异策略在学习的过程中,有两种不同的策略:目标策略(target policy)和行为策略(behavior policy)。 目标策略是我们需要去学习的策略,一般用 π 来表示。目标策略就像是在后方指挥战术的一个军师,它可以根据自己的经验来学习最优的策略,不需要去和环境交互。 行为策略是探索环境的策略,一般用 μ 来表示。行为策略可以大胆地去探索到所有可能的轨迹,采集轨迹,采集数据,然后把采集到的数据“喂”给目标策略学习。而且“喂”给目标策略的数据中并不需要 at+1*at*+1 ,而 Sarsa 是要有 at+1*at*+1 的。行为策略像是一个战士,可以在环境里面探索所有的动作、轨迹和经验,然后把这些经验交给目标策略去学习。比如目标策略优化的时候,Q学习不会管我们下一步去往哪里探索,它只选取奖励最大的策略。
在异策略学习的过程中,轨迹都是行为策略与环境交互产生的,产生这些轨迹后,我们使用这些轨迹来更新目标策略 π。 异策略学习有很多好处。首先,我们可以利用探索策略来学到最佳的策略,学习效率高; 其次,异策略学习可以让我们学习其他智能体的动作,进行模仿学习,学习人或者其他智能体产生的轨迹; 最后,异策略学习可以让我们重用旧的策略产生的轨迹,探索过程需要很多计算资源,这样可以节省资源。
Q学习有两种策略:行为策略和目标策略。 目标策略 ππ 直接在 Q表格上使用贪心策略,取它下一步能得到的所有状态,即
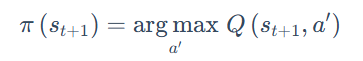
行为策略 μ 可以是一个随机的策略,但我们采取 εε-贪心策略,让行为策略不至于是完全随机的,它是基于Q表格逐渐改进的。
接着我们可以把 Q学习更新写成增量学习的形式
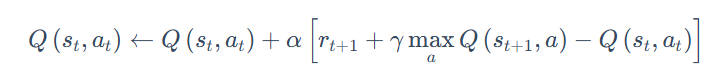
2.2 SARSA
3 策略梯度
 wechat
 alipay