Agent学习笔记
Agent学习笔记目录
- 记忆与检索
- 为什么需要记忆与RAG
- 记忆系统设计
- MEMORY
- RAG
- 上下文工程
- 什么是上下文工程
- 为什么上下文工程重要
- GSSC流水线
- NoteTool
- TerminalTool
- 智能体通信协议
- MCP
- A2A
- ANP
- Agentic-RL
记忆与检索
为什么需要记忆与RAG
借鉴人类记忆系统的设计,我们可以理解为什么智能体也需要类似的记忆能力。人类智能的一个重要特征就是能够记住过去的经历,从中学习,并将这些经验应用到新的情况中。同样,一个真正智能的智能体也需要具备记忆能力。对于基于LLM的智能体而言,通常面临两个根本性局限:对话状态的遗忘和内置知识的局限————无状态导致的对话遗忘(每一次对话是独立的),模型内置知识的局限性(LLM的知识是静态的,有限的)。
记忆与RAG的设计
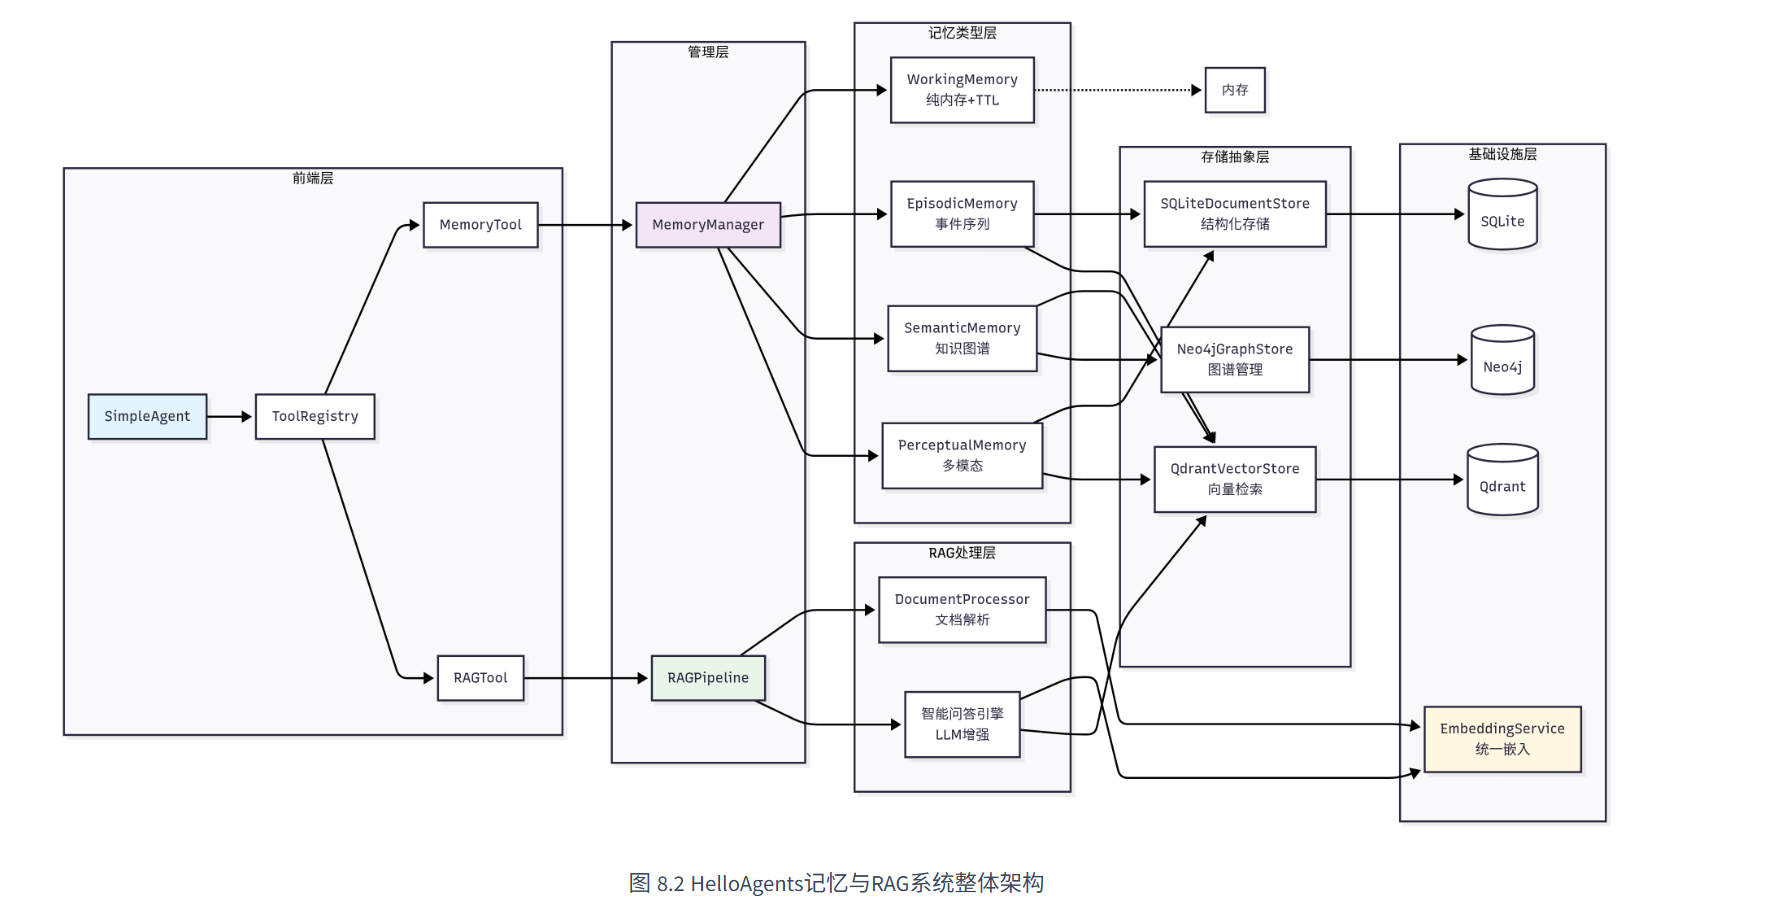
记忆系统采用了四层架构设计:
1 | HelloAgents记忆系统 |
RAG系统专注于外部知识的获取和利用:
1 | HelloAgents RAG系统 |
MEMORY
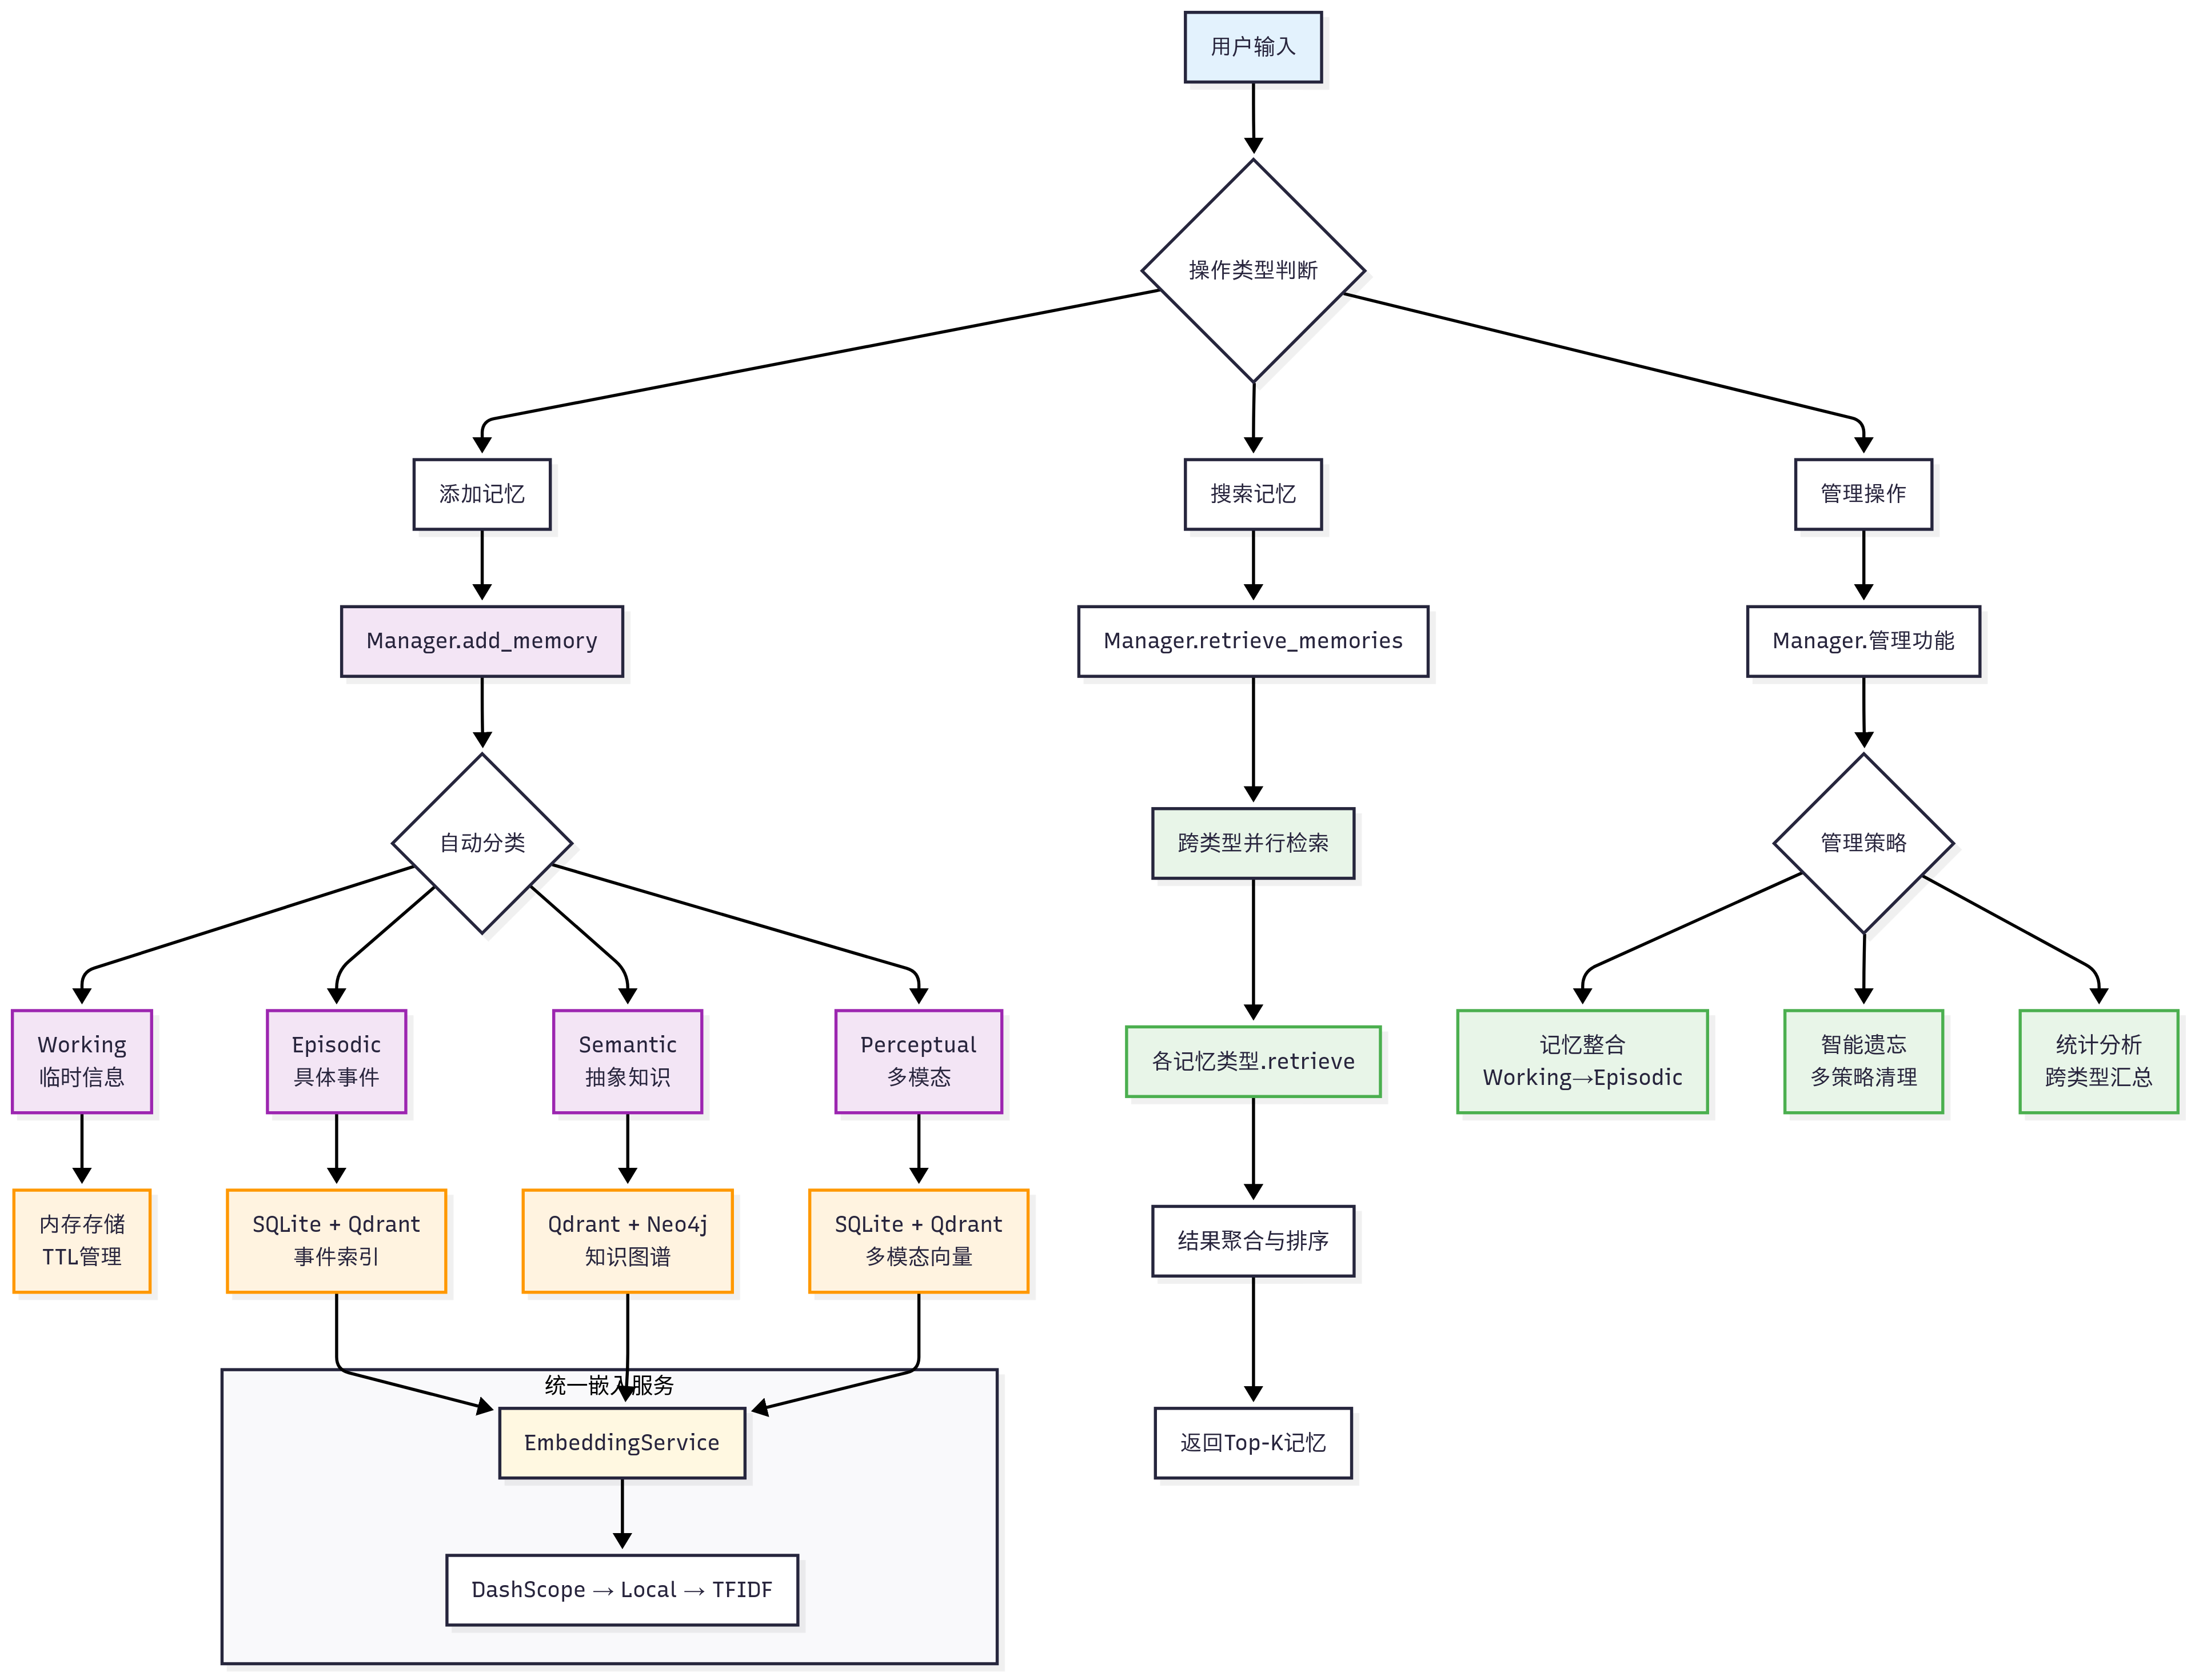
1.首先是工作记忆 (Working Memory),它扮演着智能体“短期记忆”的角色,主要用于存储当前对话的上下文信息。为确保高速访问和响应,其容量被有意限制(例如,默认50条),并且生命周期与单个会话绑定,会话结束后便会自动清理。
2.其次是情景记忆 (Episodic Memory),它负责长期存储具体的交互事件和智能体的学习经历。与工作记忆不同,情景记忆包含了丰富的上下文信息,并支持按时间序列或主题进行回顾式检索,是智能体“复盘”和学习过往经验的基础。Agent 经历过什么(经验)
3.与具体事件相对应的是语义记忆 (Semantic Memory),它存储的是更为抽象的知识、概念和规则。例如,通过对话了解到的用户偏好、需要长期遵守的指令或领域知识点,都适合存放在这里。这部分记忆具有高度的持久性和重要性,是智能体形成“知识体系”和进行关联推理的核心。Agent 知道什么(知识)
4.最后,为了与日益丰富的多媒体交互,我们引入了感知记忆 (Perceptual Memory)。该模块专门处理图像、音频等多模态信息,并支持跨模态检索。其生命周期会根据信息的重要性和可用存储空间进行动态管理。
RAG
(1)什么是RAG?
检索增强生成(Retrieval-Augmented Generation,RAG)是一种结合了信息检索和文本生成的技术。它的核心思想是:在生成回答之前,先从外部知识库中检索相关信息,然后将检索到的信息作为上下文提供给大语言模型,从而生成更准确、更可靠的回答。
因此,检索增强生成可以拆分为三个词汇。检索是指从知识库中查询相关内容;增强是将检索结果融入提示词,辅助模型生成;生成则输出兼具准确性与透明度的答案。
(2)基本工作流程
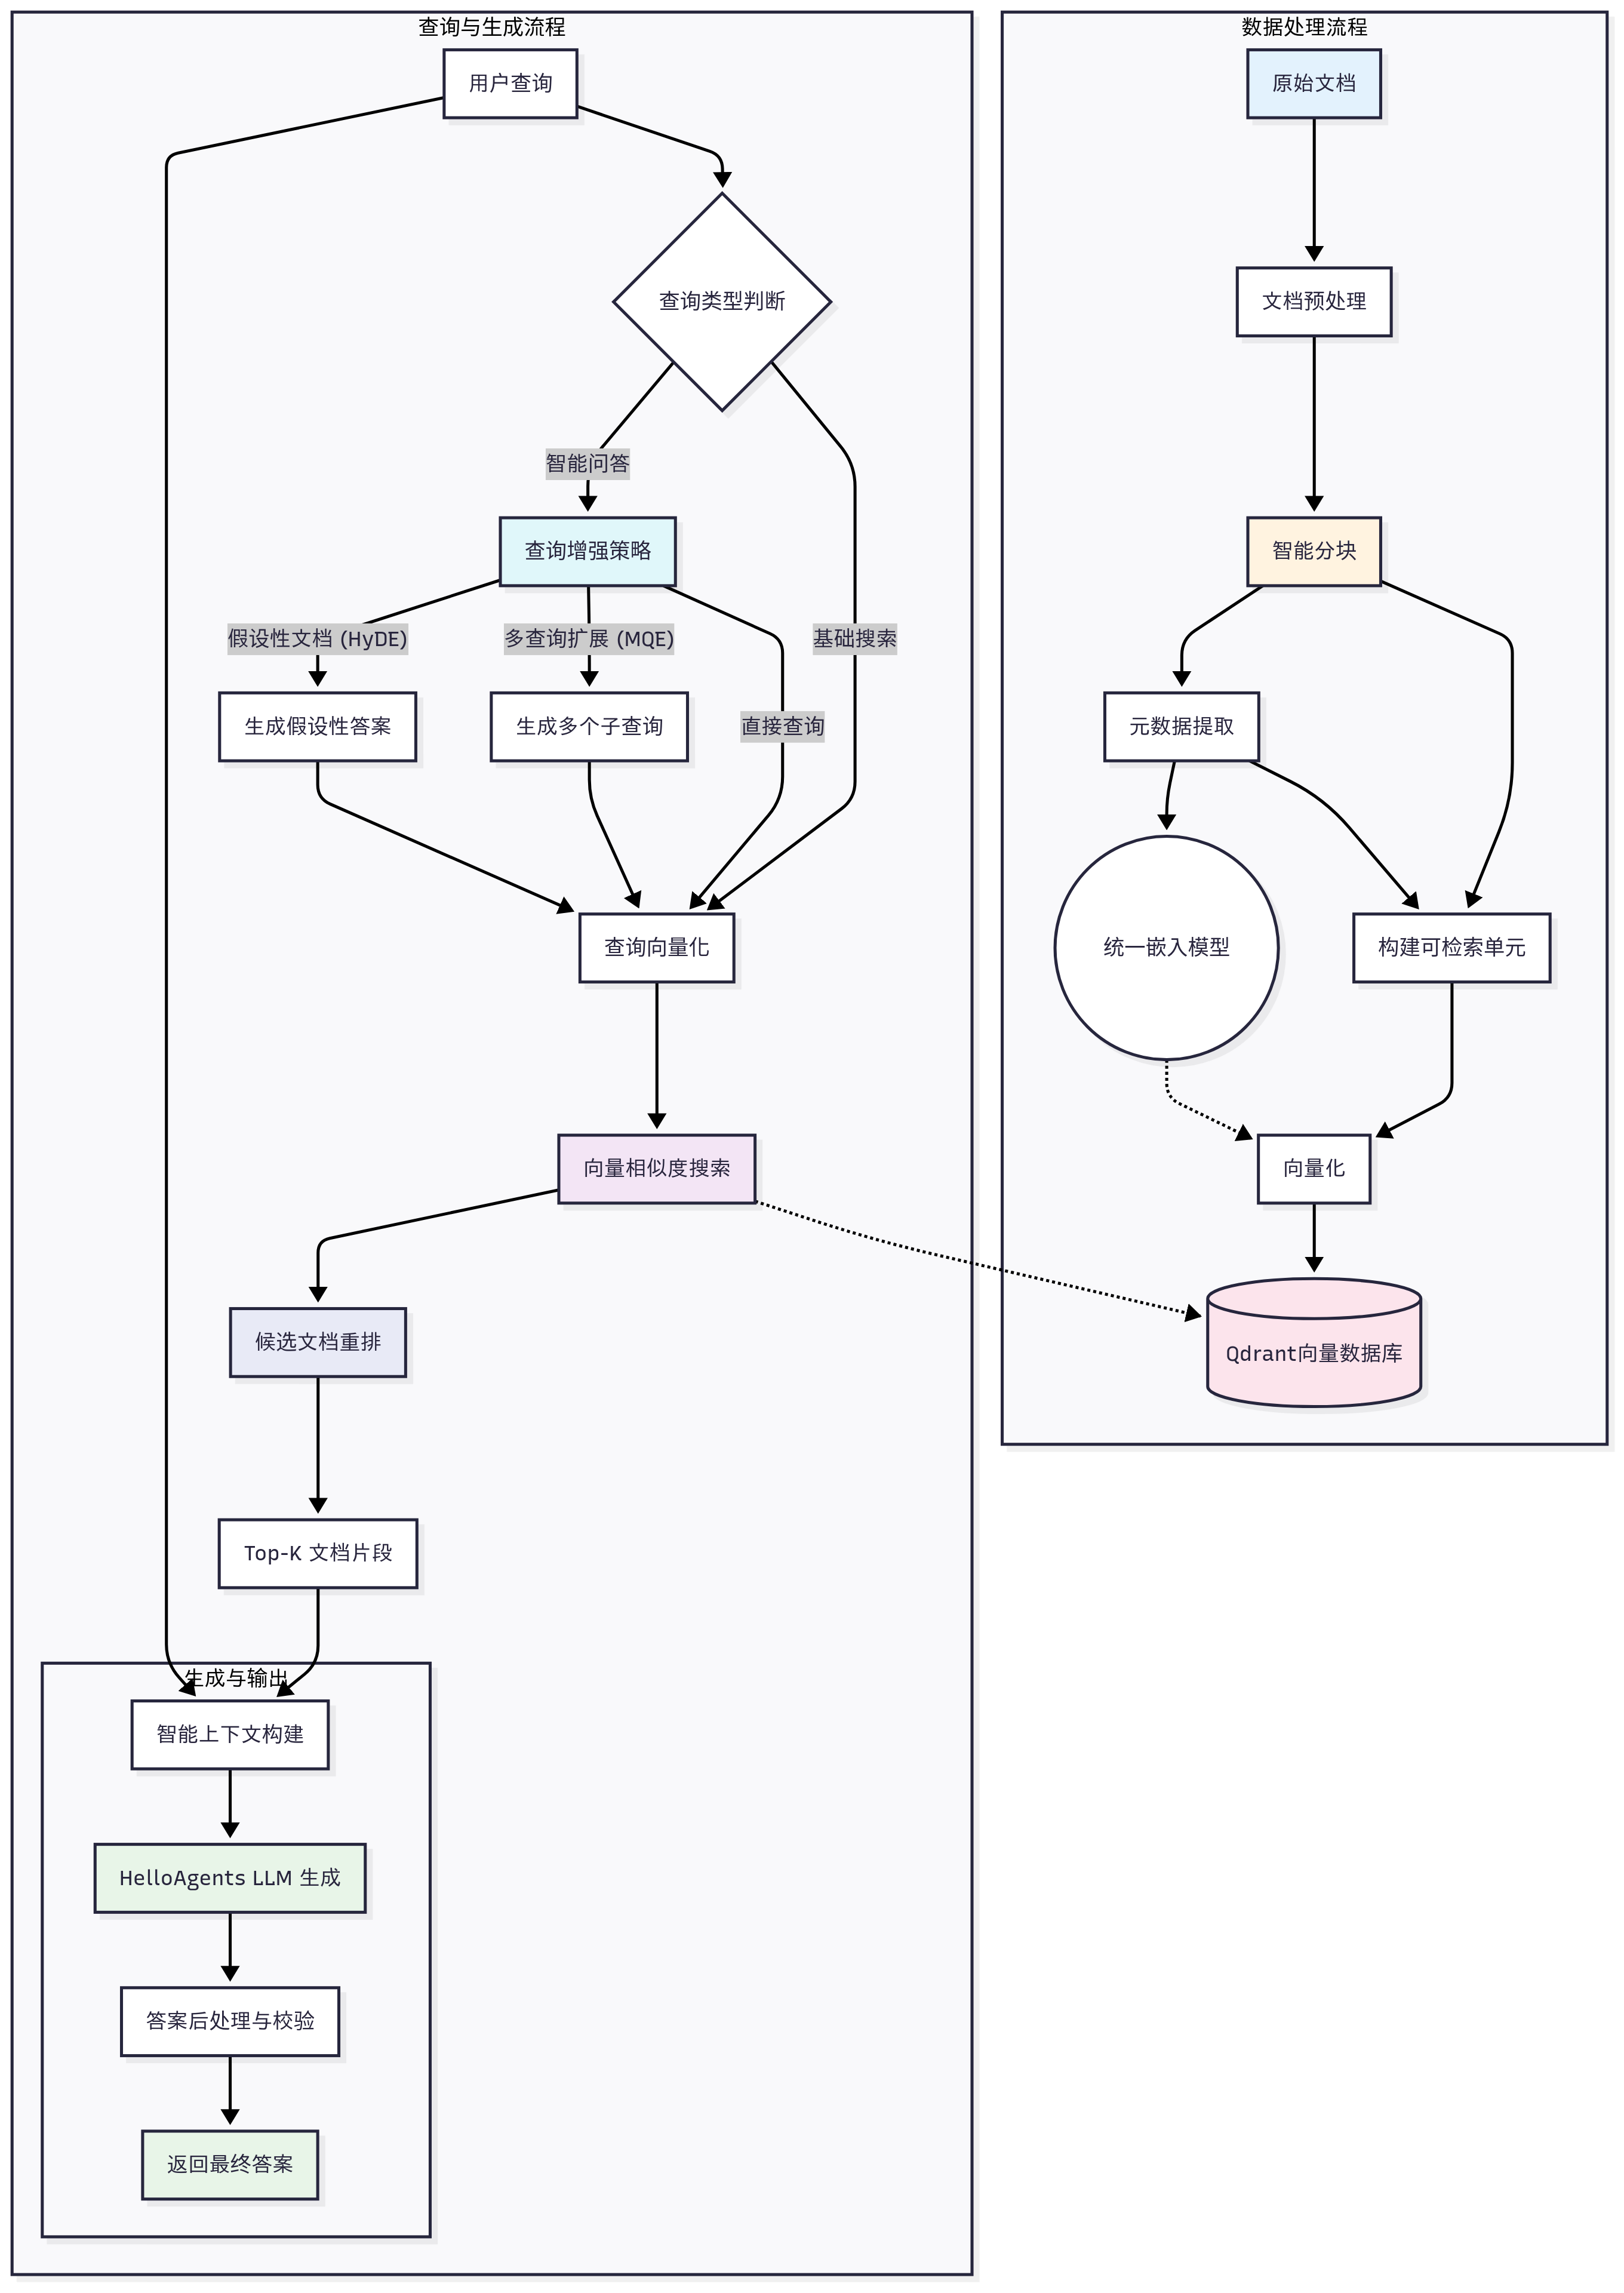
一个完整的RAG应用流程主要分为两大核心环节。在数据准备阶段,系统通过数据提取、文本分割和向量化,将外部知识构建成一个可检索的数据库。随后在应用阶段,系统会响应用户的提问,从数据库中检索相关信息,将其注入Prompt,并最终驱动大语言模型生成答案。
RAG工作原理
高级检索策略
RAG系统的检索能力是其核心竞争力。在实际应用中,用户的查询表述与文档中的实际内容可能存在用词差异,导致相关文档无法被检索到。为了解决这个问题,HelloAgents实现了三种互补的高级检索策略:多查询扩展(MQE)、假设文档嵌入(HyDE)和统一的扩展检索框架。
多查询扩展(MQE)
多查询扩展(Multi-Query Expansion)是一种通过生成语义等价的多样化查询来提高检索召回率的技术。这种方法的核心洞察是:同一个问题可以有多种不同的表述方式,而不同的表述可能匹配到不同的相关文档。例如,”如何学习Python”可以扩展为”Python入门教程”、”Python学习方法”、”Python编程指南”等多个查询。通过并行执行这些扩展查询并合并结果,系统能够覆盖更广泛的相关文档,避免因用词差异而遗漏重要信息。
MQE的优势在于它能够自动理解用户查询的多种可能含义,特别是对于模糊查询或专业术语查询效果显著。系统使用LLM生成扩展查询,确保扩展的多样性和语义相关性:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15def _prompt_mqe(query: str, n: int) -> List[str]:
"""使用LLM生成多样化的查询扩展"""
try:
from ...core.llm import HelloAgentsLLM
llm = HelloAgentsLLM()
prompt = [
{"role": "system", "content": "你是检索查询扩展助手。生成语义等价或互补的多样化查询。使用中文,简短,避免标点。"},
{"role": "user", "content": f"原始查询:{query}\n请给出{n}个不同表述的查询,每行一个。"}
]
text = llm.invoke(prompt)
lines = [ln.strip("- \t") for ln in (text or "").splitlines()]
outs = [ln for ln in lines if ln]
return outs[:n] or [query]
except Exception:
return [query]假设文档嵌入(HyDE)
假设文档嵌入(Hypothetical Document Embeddings,HyDE)是一种创新的检索技术,它的核心思想是”用答案找答案”。传统的检索方法是用问题去匹配文档,但问题和答案在语义空间中的分布往往存在差异——问题通常是疑问句,而文档内容是陈述句。HyDE通过让LLM先生成一个假设性的答案段落,然后用这个答案段落去检索真实文档,从而缩小了查询和文档之间的语义鸿沟。
这种方法的优势在于,假设答案与真实答案在语义空间中更加接近,因此能够更准确地匹配到相关文档。即使假设答案的内容不完全正确,它所包含的关键术语、概念和表述风格也能有效引导检索系统找到正确的文档。特别是对于专业领域的查询,HyDE能够生成包含领域术语的假设文档,显著提升检索精度:
1
2
3
4
5
6
7
8
9
10
11
12
13def _prompt_hyde(query: str) -> Optional[str]:
"""生成假设性文档用于改善检索"""
try:
from ...core.llm import HelloAgentsLLM
llm = HelloAgentsLLM()
prompt = [
{"role": "system", "content": "根据用户问题,先写一段可能的答案性段落,用于向量检索的查询文档(不要分析过程)。"},
{"role": "user", "content": f"问题:{query}\n请直接写一段中等长度、客观、包含关键术语的段落。"}
]
return llm.invoke(prompt)
except Exception:
return None扩展检索框架
HelloAgents将MQE和HyDE两种策略整合到统一的扩展检索框架中。系统通过
enable_mqe和enable_hyde参数让用户可以根据具体场景选择启用哪些策略:对于需要高召回率的场景可以同时启用两种策略,对于性能敏感的场景可以只使用基础检索。扩展检索的核心机制是”扩展-检索-合并“三步流程。首先,系统根据原始查询生成多个扩展查询(包括MQE生成的多样化查询和HyDE生成的假设文档);然后,对每个扩展查询并行执行向量检索,获取候选文档池;最后,通过去重和分数排序合并所有结果,返回最相关的top-k文档。这种设计的巧妙之处在于,它通过
candidate_pool_multiplier参数(默认为4)扩大候选池,确保有足够的候选文档进行筛选,同时通过智能去重避免返回重复内容。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72def search_vectors_expanded(
store = None,
query: str = "",
top_k: int = 8,
rag_namespace: Optional[str] = None,
only_rag_data: bool = True,
score_threshold: Optional[float] = None,
enable_mqe: bool = False,
mqe_expansions: int = 2,
enable_hyde: bool = False,
candidate_pool_multiplier: int = 4,
) -> List[Dict]:
"""
Search with query expansion using unified embedding and Qdrant.
"""
if not query:
return []
# 创建默认存储
if store is None:
store = _create_default_vector_store()
# 查询扩展
expansions: List[str] = [query]
if enable_mqe and mqe_expansions > 0:
expansions.extend(_prompt_mqe(query, mqe_expansions))
if enable_hyde:
hyde_text = _prompt_hyde(query)
if hyde_text:
expansions.append(hyde_text)
# 去重和修剪
uniq: List[str] = []
for e in expansions:
if e and e not in uniq:
uniq.append(e)
expansions = uniq[: max(1, len(uniq))]
# 分配候选池
pool = max(top_k * candidate_pool_multiplier, 20)
per = max(1, pool // max(1, len(expansions)))
# 构建RAG数据过滤器
where = {"memory_type": "rag_chunk"}
if only_rag_data:
where["is_rag_data"] = True
where["data_source"] = "rag_pipeline"
if rag_namespace:
where["rag_namespace"] = rag_namespace
# 收集所有扩展查询的结果
agg: Dict[str, Dict] = {}
for q in expansions:
qv = embed_query(q)
hits = store.search_similar(
query_vector=qv,
limit=per,
score_threshold=score_threshold,
where=where
)
for h in hits:
mid = h.get("metadata", {}).get("memory_id", h.get("id"))
s = float(h.get("score", 0.0))
if mid not in agg or s > float(agg[mid].get("score", 0.0)):
agg[mid] = h
# 按分数排序返回
merged = list(agg.values())
merged.sort(key=lambda x: float(x.get("score", 0.0)), reverse=True)
return merged[:top_k]
实际应用中,这三种策略的组合使用效果最佳。MQE擅长处理用词多样性问题,HyDE擅长处理语义鸿沟问题,而统一框架则确保了结果的质量和多样性。对于一般查询,建议启用MQE;对于专业领域查询,建议同时启用MQE和HyDE;对于性能敏感场景,可以只使用基础检索或仅启用MQE。
上下文工程
然而,要让智能体在真实复杂场景中稳定地“思考”与“行动”,仅有记忆与检索还不够——我们需要一套工程化方法,持续、系统地为模型构造恰当的“上下文”。这就是本章的主题:上下文工程(Context Engineering)。它关注的是“在每一次模型调用前,如何以可复用、可度量、可演进的方式,拼装并优化输入上下文”,从而提升正确性、鲁棒性与效率。
什么是上下文工程
所谓“上下文”,是指在对大语言模型(LLM)进行采样时所包含的那组 tokens。手头的工程问题,是在 LLM 的固有约束之下,优化这些 tokens 的效用,以便稳定地得到预期结果。想要有效驾驭 LLM,往往需要“在上下文中思考”——也就是说:在任何一次调用时,都要审视 LLM 可见的整体状态,并预判这种状态可能诱发的行为。

上写文工程 VS 提示词工程
在 LLM 工程的早期阶段,提示往往是主要工作,因为大多数用例(除日常聊天外)都需要针对单轮分类或文本生成做精调式的提示优化。顾名思义,提示工程的核心是“如何写出有效提示”,尤其是系统提示。然而,随着我们开始工程化地构建更强的智能体,它们在更长的时间范围内、跨多次推理轮次地工作,我们就需要能管理整个上下文状态的策略——其中包括系统指令、工具、MCP(Model Context Protocol)、外部数据、消息历史等。
一个循环运行的智能体,会不断产生下一轮推理可能相关的数据,这些信息必须被周期性地提炼。因此,上下文工程的“艺与术”,在于从持续扩张的“候选信息宇宙”中,甄别哪些内容应当进入有限的上下文窗口。
为什么上下文工程重要
尽管模型的速度越来越快、可处理的数据规模越来越大,但我们观察到:LLM 和人类一样,在一定点上会“走神”或“混乱”。针堆找针(needle-in-a-haystack)类基准揭示了一个现象:上下文腐蚀(context rot)——随着上下文窗口中的 tokens 增加,模型从上下文中准确回忆信息的能力反而下降。
不同模型的退化曲线或许更平滑,但这一特征几乎在所有模型上都会出现。因此,上下文必须被视作一种有限资源,且具有边际收益递减。就像人类有有限的工作记忆容量一样,LLM 也有一笔“注意力预算”。每新增一个 token,都会消耗这笔预算的一部分,因此我们更需要谨慎地筛选哪些 tokens 应该被提供给 LLM。
这种稀缺并非偶然,而是源自 LLM 的架构约束。Transformer 让每个 token 能够与上下文中的所有 token 建立关联,理论上形成 (n^2) 级别的两两注意力关系。随着上下文长度增长,模型对这些两两关系的建模能力会被“拉薄”,从而自然地产生“上下文规模”与“注意力集中度”的张力。此外,模型的注意力模式来源于训练数据分布——短序列通常比长序列更常见,因此模型对“全上下文依赖”的经验更少、专门参数也更少。
诸如位置编码插值(position encoding interpolation)等技术可以让模型在推理时“适配”比训练期更长的序列,但会牺牲部分对 token 位置的精确理解。总体上,这些因素共同形成的是一个性能梯度,而非“悬崖式”崩溃:模型在长上下文下依旧强大,但相较短上下文,在信息检索与长程推理上的精度会有所下降。
基于上述现实,有意识的上下文工程就成为构建强健智能体的必需品。
面对长时程任务
长时程任务要求智能体在超出上下文窗口的长序列行动中,仍能保持连贯性、上下文一致与目标导向。例如大型代码库迁移、跨数小时的系统性研究。指望无限增大上下文窗口并不能根治“上下文污染”与相关性退化的问题,因此需要直接面向这些约束的工程手段:压缩整合(Compaction)、结构化笔记(Structured note-taking)与子代理架构(Sub-agent architectures)。
压缩整合
- 定义:当对话接近上下文上限时,对其进行高保真总结,并用该摘要重启一个新的上下文窗口,以维持长程连贯性。
- 实践:让模型压缩并保留架构性决策、未解决缺陷、实现细节,丢弃重复的工具输出与噪声;新窗口携带压缩摘要 + 最近少量高相关工件(如“最近访问的若干文件”)。
- 调参建议:先优化召回(确保不遗漏关键信息),再优化精确度(剔除冗余内容);一种安全的“轻触式”压缩是对“深历史中的工具调用与结果”进行清理。
结构化笔记
- 定义:也称“智能体记忆”。智能体以固定频率将关键信息写入上下文外的持久化存储,在后续阶段按需拉回。
- 价值:以极低的上下文开销维持持久状态与依赖关系。例如维护 TODO 列表、项目 NOTES.md、关键结论/依赖/阻塞项的索引,跨数十次工具调用与多轮上下文重置仍能保持进度与一致性。
- 说明:在非编码场景中同样有效(如长期策略性任务、游戏/仿真中的目标管理与统计计数)。结合第八章的
MemoryTool,可轻松实现文件式/向量式的外部记忆并在运行时检索。
子代理架构
思想:由主代理负责高层规划与综合,多个专长子代理在“干净的上下文窗口”中各自深挖、调用工具并探索,最后仅回传凝练摘要(常见 1,000–2,000 tokens)。
好处:实现关注点分离。庞杂的搜索上下文留在子代理内部,主代理专注于整合与推理;适合需要并行探索的复杂研究/分析任务。
经验:公开的多智能体研究系统显示,该模式在复杂研究任务上相较单代理基线具有显著优势。
压缩整合:适合需要长对话连续性的任务,强调上下文的“接力”。
结构化笔记:适合有里程碑/阶段性成果的迭代式开发与研究。
子代理架构:适合复杂研究与分析,能从并行探索中获益。
GSSC流水线
ContextBuilder 的核心是 GSSC(Gather-Select-Structure-Compress)流水线,它将上下文构建过程分解为四个清晰的阶段。
Gather:多源信息汇集
第一阶段是从多个来源汇集候选信息。这个阶段的关键在于容错性和灵活性。
- 容错机制:每个外部数据源的调用都被 try-except 包裹,确保单个源的失败不会影响整体流程
- 优先级处理:系统指令被标记为高优先级,确保始终被保留
- 历史限制:对话历史只保留最近的几条,避免上下文窗口被历史信息占据
Select:智能信息选择
第二阶段是根据相关性和新近性对候选信息进行评分和选择。这是整个流水线的核心,直接决定了最终上下文的质量。
- 评分机制:采用相关性和新近性的加权组合,权重可配置
- 贪心算法:按分数从高到低填充,确保在有限预算内选择最有价值的信息
- 过滤机制:通过
min_relevance参数过滤低质量信息
Structure:结构化输出
第三阶段是将选中的信息组织成结构化的上下文模板。
- 可读性:清晰的分区让人类和模型都更容易理解上下文结构
- 可调试性:问题定位更容易,可以快速识别哪个区域的信息有问题
- 可扩展性:添加新的信息源只需要创建新的分区
Compress:兜底压缩
第四阶段是对超限上下文进行压缩处理。
NoteTool:结构化笔记
NoteTool 是为”长时程任务”提供的结构化外部记忆组件。它以 Markdown 文件作为载体,头部使用 YAML 前置元数据记录关键信息,正文用于记录状态、结论、阻塞与行动项等内容。这种设计结合了人类可读性、版本控制友好性和易于回注上下文的特性,是构建长时程智能体的重要工具。
设计理念
为什么需要结构化笔记?
MemoryTool,它提供了强大的记忆管理能力。然而,MemoryTool 主要关注对话式记忆——短期工作记忆、情景记忆和语义记忆。对于需要长期追踪、结构化管理的项目式任务,我们需要一种更轻量、更人类友好的记录方式。
NoteTool 填补了这个gap,它提供了:
- 结构化记录:使用 Markdown + YAML 格式,既适合机器解析,也方便人类阅读和编辑
- 版本友好:纯文本格式,天然支持 Git 等版本控制系统
- 低开销:无需复杂的数据库操作,适合轻量级的状态追踪
- 灵活分类:通过
type和tags灵活组织笔记,支持多维度检索
应用场景
长期项目跟踪
想象一个智能体正在协助完成一个大型代码库的重构任务,这可能需要几天甚至几周。NoteTool 可以记录:
task_state:当前阶段的任务状态和进度conclusion:每个阶段结束后的关键结论blocker:遇到的问题和阻塞点action:下一步的行动计划
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17# 记录任务状态
notes.run({
"action": "create",
"title": "重构项目 - 第一阶段",
"content": "已完成数据模型层的重构,测试覆盖率达到85%。下一步将重构业务逻辑层。",
"note_type": "task_state",
"tags": ["refactoring", "phase1"]
})
# 记录阻塞点
notes.run({
"action": "create",
"title": "依赖冲突问题",
"content": "发现某些第三方库版本不兼容,需要解决。影响范围:业务逻辑层的3个模块。",
"note_type": "blocker",
"tags": ["dependency", "urgent"]
})研究任务管理
一个智能研究助手在进行文献综述时,可以使用 NoteTool 记录:
- 每篇论文的核心观点(
conclusion) - 待深入调研的主题(
action) - 重要的参考文献(
reference)
- 每篇论文的核心观点(
与ContextBuilder配合
在每轮对话前,Agent 可以通过
search或list操作检索相关笔记,并将其注入到上下文中:1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26# 在 Agent 的 run 方法中
def run(self, user_input: str) -> str:
# 1. 检索相关笔记
relevant_notes = self.note_tool.run({
"action": "search",
"query": user_input,
"limit": 3
})
# 2. 将笔记内容转换为 ContextPacket
note_packets = []
for note in relevant_notes:
note_packets.append(ContextPacket(
content=note['content'],
timestamp=note['updated_at'],
token_count=self._count_tokens(note['content']),
relevance_score=0.7,
metadata={"type": "note", "note_type": note['type']}
))
# 3. 构建上下文时传入笔记
context = self.context_builder.build(
user_query=user_input,
custom_packets=note_packets,
...
)
TerminalTool:即时文件系统访问
MemoryTool 和 RAGTool,它们分别提供了对话记忆和知识检索能力。然而,在许多实际场景中,智能体需要即时访问和探索文件系统——查看日志文件、分析代码库结构、检索配置文件等。这就是 TerminalTool 的用武之地。
TerminalTool 为智能体提供了安全的命令行执行能力,支持常用的文件系统和文本处理命令,同时通过多层安全机制确保系统安全。这种设计实现了 9.2.2 节提到的”即时(Just-in-time, JIT)上下文”理念——智能体不需要预先加载所有文件,而是按需探索和检索。
设计理念与安全机制
(1)为什么需要 TerminalTool?
在构建长程智能体时,我们经常遇到以下场景:
场景1:代码库探索
一个开发助手需要帮助用户理解一个大型代码库的结构:
1 |
|
场景2:日志文件分析
一个运维助手需要分析应用日志:
1 |
|
场景3:数据文件预览
一个数据分析助手需要快速了解数据文件的结构:
1 |
|
这些场景的共同特点是:需要实时、轻量级的文件系统访问,而不是预先索引和向量化。TerminalTool 正是为这种”探索式”工作流设计的。
(2)安全机制详解
允许智能体执行命令是一个强大但危险的能力。TerminalTool 通过多层安全机制确保系统安全:
第一层:命令白名单
只允许安全的只读命令,完全禁止任何可能修改系统的操作:
1 | ALLOWED_COMMANDS = { |
如果智能体尝试执行白名单外的命令,会立即被拒绝:
1 | terminal.run({"command": "rm -rf /"}) |
第二层:工作目录限制(沙箱)
TerminalTool 只能访问指定的工作目录及其子目录,无法访问系统其他部分:
1 |
|
这种沙箱机制确保了即使智能体的行为出现异常,也无法影响系统其他部分。
第三层:超时控制
每个命令都有执行时间限制,防止无限循环或资源耗尽:
1 | terminal = TerminalTool( |
第四层:输出大小限制
限制命令输出的大小,防止内存溢出:
1 | terminal = TerminalTool( |
通过这四层安全机制,TerminalTool 在提供强大能力的同时,最大程度地保证了系统安全。
智能体通信协议
**MCP(Model Context Protocol)**用于智能体与工具的标准化通信,**A2A(Agent-to-Agent Protocol)**用于智能体间的点对点协作,**ANP(Agent Network Protocol)**用于构建大规模智能体网络。这三种协议共同构成了智能体通信的基础设施层。
智能体通信协议基础
通信协议的核心价值正是解决这些问题(代码重复(每个工具都要处理 HTTP 请求、错误处理、认证等),难以维护(API 变更需要修改所有相关工具),无法复用(其他开发者的工具无法直接使用),扩展性差(添加新服务需要大量编码工作))。它提供了一套标准化的接口规范,让智能体能够以统一的方式访问各种外部服务,而无需为每个服务编写专门的适配器。这就像互联网的 TCP/IP 协议,它让不同的设备能够相互通信,而不需要为每种设备编写专门的通信代码。
通信协议带来的改变是根本性的:标准化接口让不同服务提供统一的访问方式,互操作性使得不同开发者的工具可以无缝集成,动态发现允许智能体在运行时发现新的服务和能力,可扩展性让系统能够轻松添加新的功能模块。
三种协议设计理念
MCP:智能体与工具的桥梁
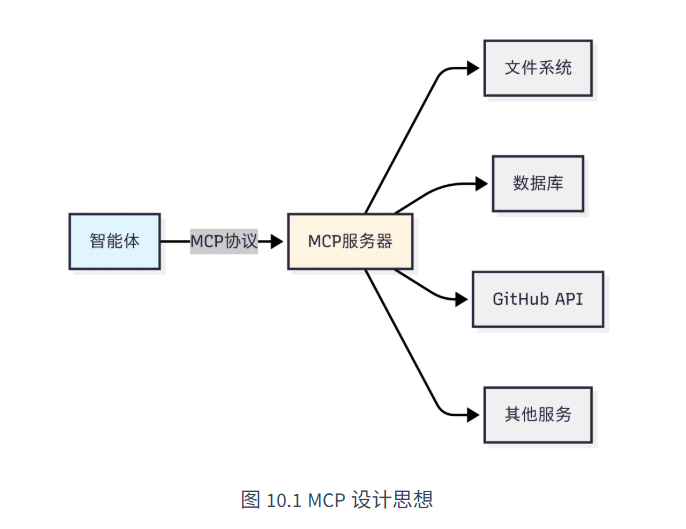
MCP(Model Context Protocol)由 Anthropic 团队提出[1],其核心设计理念是标准化智能体与外部工具/资源的通信方式。想象一下,你的智能体需要访问文件系统、数据库、GitHub、Slack 等各种服务。传统做法是为每个服务编写专门的适配器,这不仅工作量大,而且难以维护。MCP 通过定义统一的协议规范,让所有服务都能以相同的方式被访问。
MCP 的设计哲学是”上下文共享”。它不仅仅是一个 RPC(远程过程调用)协议,更重要的是它允许智能体和工具之间共享丰富的上下文信息。如图 10.1 所示,当智能体访问一个代码仓库时,MCP 服务器不仅能提供文件内容,还能提供代码结构、依赖关系、提交历史等上下文信息,让智能体能够做出更智能的决策。
A2A:智能体间的对话
A2A(Agent-to-Agent Protocol)协议由 Google 团队提出2,其核心设计理念是实现智能体之间的点对点通信。与 MCP 关注智能体与工具的通信不同,A2A 关注的是智能体之间如何相互协作。这种设计让智能体能够像人类团队一样进行对话、协商和协作。
A2A 的设计哲学是”对等通信”。如图 10.2 所示,在 A2A 网络中,每个智能体既是服务提供者,也是服务消费者。智能体可以主动发起请求,也可以响应其他智能体的请求。这种对等的设计避免了中心化协调器的瓶颈,让智能体网络更加灵活和可扩展。

ANP:智能体网络的基础设施
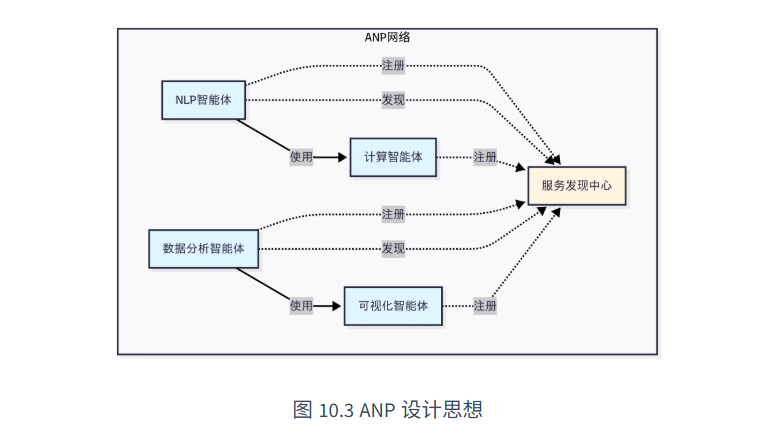
ANP(Agent Network Protocol)是一个概念性的协议框架3,目前由开源社区维护,还没有成熟的生态,其核心设计理念是构建大规模智能体网络的基础设施。如果说 MCP 解决的是”如何访问工具”,A2A 解决的是”如何与其他智能体对话”,那么 ANP 解决的是”如何在大规模网络中发现和连接智能体”。
ANP 的设计哲学是”去中心化服务发现”。在一个包含成百上千个智能体的网络中,如何让智能体能够找到它需要的服务?如图 10.3 所示,ANP 提供了服务注册、发现和路由机制,让智能体能够动态地发现网络中的其他服务,而不需要预先配置所有的连接关系。
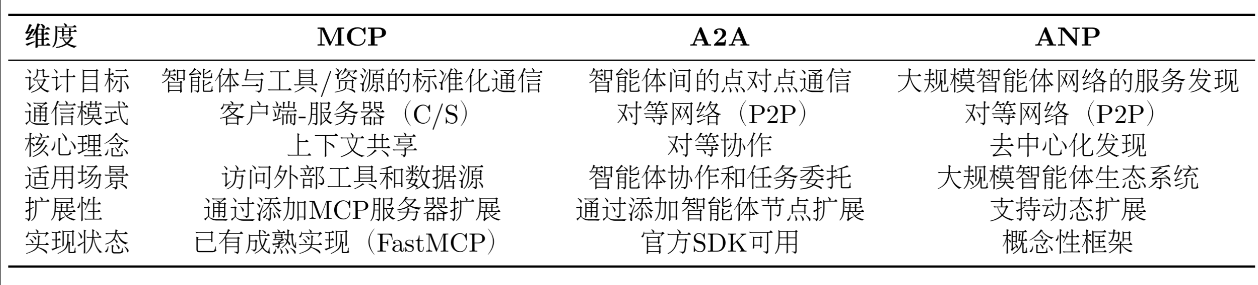
三种理念的对比:
如何先择合适的协议?
目前的协议还处于发展早期,MCP 的生态相对成熟,不过各种工具的时效性取决于维护者,更推荐选择大公司背书的 MCP 工具。
选择协议的关键在于理解你的需求:
- 如果你的智能体需要访问外部服务(文件、数据库、API),选择MCP
- 如果你需要多个智能体相互协作完成任务,选择A2A
- 如果你要构建大规模的智能体生态系统,考虑ANP
MCP
MCP协议概念
MCP的架构
MCP 协议采用 Host、Client、Servers 三层架构设计,让我们通过图 10.5 的场景来理解这些组件如何协同工作。
假设你正在使用 Claude Desktop 询问:”我桌面上有哪些文档?”

三层架构的职责:
- Host(宿主层):Claude Desktop 作为 Host,负责接收用户提问并与 Claude 模型交互。Host 是用户直接交互的界面,它管理整个对话流程。
- Client(客户端层):当 Claude 模型决定需要访问文件系统时,Host 中内置的 MCP Client 被激活。Client 负责与适当的 MCP Server 建立连接,发送请求并接收响应。
- Server(服务器层):文件系统 MCP Server 被调用,执行实际的文件扫描操作,访问桌面目录,并返回找到的文档列表。
**完整的交互流程:**用户问题 → Claude Desktop(Host) → Claude 模型分析 → 需要文件信息 → MCP Client 连接 → 文件系统 MCP Server → 执行操作 → 返回结果 → Claude 生成回答 → 显示在 Claude Desktop 上
这种架构设计的优势在于关注点分离:Host 专注于用户体验,Client 专注于协议通信,Server 专注于具体功能实现。开发者只需专注于开发对应的 MCP Server,无需关心 Host 和 Client 的实现细节。
核心能力
MCP 协议提供了三大核心能力,构成完整的工具访问框架:
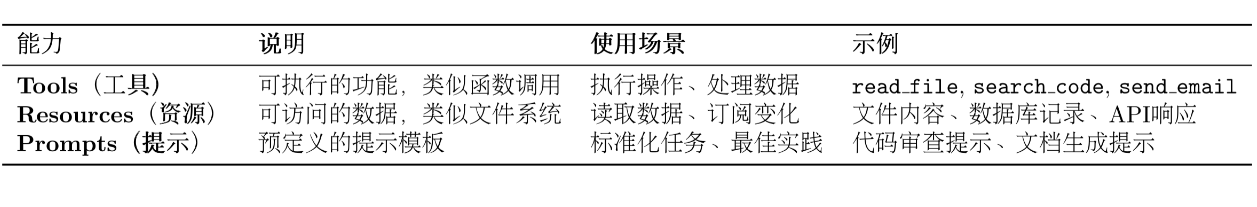 这三种能力的区别在于:Tools 是主动的(执行操作),Resources 是被动的(提供数据),Prompts 是指导性的(提供模板)。
工作流程
通过一个具体例子来理解 MCP 的完整工作流程

一个关键问题是:Claude(或其他 LLM)是如何决定使用哪些工具的?
当用户提出问题时,完整的工具选择流程如下:
工具发现阶段:MCP Client 连接到 Server 后,首先调用
list_tools()获取所有可用工具的描述信息(包括工具名称、功能说明、参数定义)上下文构建:Client 将工具列表转换为 LLM 能理解的格式,添加到系统提示词中。例如:
1
2
3
你可以使用以下工具:
- read_file(path: str): 读取指定路径的文件内容
- search_code(query: str, language: str): 在代码库中搜索Copy to clipboardErrorCopied模型推理:LLM 分析用户问题和可用工具,决定是否需要调用工具以及调用哪个工具。这个决策基于工具的描述和当前对话上下文
工具执行:如果 LLM 决定使用工具,Client 通过 MCP Server 执行所选工具,获取结果
结果整合:工具执行结果被送回给 LLM,LLM 结合结果生成最终回答
这个过程是完全自动化的,LLM 会根据工具描述的质量来决定是否使用以及如何使用工具。因此,编写清晰、准确的工具描述至关重要。
MCP 与 Function Calling 的差异

首先需要明确的是,Function Calling 与 MCP 并非竞争关系,而是相辅相成的。Function Calling 是大语言模型的一项核心能力,它体现了模型内在的智能,使模型能够理解何时需要调用函数,并精准生成相应的调用参数。相对地,MCP 则扮演着基础设施协议的角色,它在工程层面解决了工具与模型如何连接的问题,通过标准化的方式来描述和调用工具。
我们可以用一个简单的类比来理解:Function Calling 相当于你学会了“如何打电话”这项技能,包括何时拨号、如何与对方沟通、何时挂断。而 MCP 则是那个全球统一的“电话通信标准”,确保了任何一部电话都能顺利地拨通另一部。
MCP传输方式
MCP 协议的一个重要特性是传输层无关性(Transport Agnostic)。这意味着 MCP 协议本身不依赖于特定的传输方式,可以在不同的通信通道上运行。
HelloAgents 的MCPClient支持五种传输方式,每种都有不同的使用场景,如表 10.4 所示:
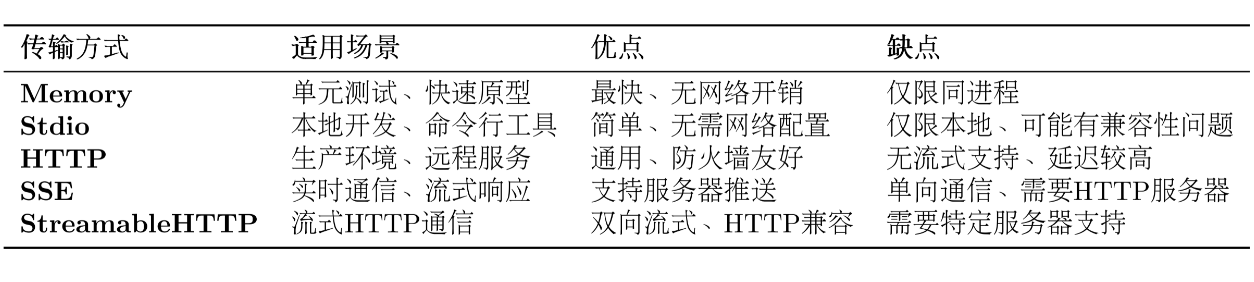
Memory Transport - 内存传输
Memory 是内存传输,客户端和服务器在同一个进程里直接通信。
它不需要网络,也不需要启动独立服务器,速度最快,适合:
1 | 单元测试、快速验证、原型开发 |
优点是简单、快、没有网络开销。缺点也很明显:只能在同一个进程里用,不能跨机器,也不适合真实部署。
可以理解为:
客户端和 MCP Server 直接在程序内部互相调用。
适用场景:单元测试、快速原型开发
1 | from hello_agents.tools import MCPTool |
Stdio Transport - 标准输入输出传输
Stdio 是通过标准输入输出通信,也就是客户端启动一个子进程,然后通过 stdin/stdout 和它交互。
你之前运行的:
1 | npx -y @modelcontextprotocol/server-filesystem . |
就是典型的 Stdio 方式。
适合:
1 | 本地开发、命令行工具、本地文件系统工具、桌面应用调用本地 MCP Server |
优点是配置简单,不需要开 HTTP 服务。缺点是一般只适合本地,同一台机器上用;如果子进程没有正确关闭,在 Windows 上可能出现你之前遇到的:
1 | RuntimeError: Event loop is closed |
可以理解为:
客户端启动 MCP Server 子进程,然后通过命令行管道通信。
适用场景:本地开发、调试、Python 脚本服务器
1 | from hello_agents.tools import MCPTool |
HTTP Transport - HTTP 传输
HTTP 是最通用的网络通信方式。MCP Server 作为一个 Web 服务运行,客户端通过 HTTP 请求访问它。
适合:
1 | 生产环境、远程服务、跨机器调用、云端部署 |
优点是通用、稳定,容易接入防火墙、网关、鉴权、日志系统。缺点是普通 HTTP 请求一般是一次请求一次响应,不天然适合持续流式输出,实时性比本地 Stdio 低一些。
可以理解为:
MCP Server 部署成一个远程 API 服务,客户端通过 URL 调用。
适用场景:生产环境、远程服务、微服务架构
1 |
|
SSE Transport - Server-Sent Events 传输
SSE 全称是 Server-Sent Events,意思是服务器推送事件。
它本质上仍然基于 HTTP,但支持服务器持续向客户端推送消息。
适合:
1 | 实时通信、流式响应、服务器持续返回结果 |
例如模型生成内容、任务执行进度、日志流式返回等。
优点是支持服务器主动推送,适合流式输出。缺点是它通常是单向通信:服务器可以持续推给客户端,但客户端不能在同一条连接里双向流式通信。并且它需要一个 HTTP Server。
可以理解为:
客户端连上服务器后,服务器可以不断往客户端发消息。
适用场景:实时通信、流式处理、长连接
1 |
|
StreamableHTTP Transport - 流式 HTTP 传输
StreamableHTTP 可以理解为更适合 MCP 的流式 HTTP 传输方式。
它既保留了 HTTP 的兼容性,又支持更好的流式通信能力,适合需要长连接、流式工具调用、远程 MCP 服务的场景。
适合:
1 | 流式 HTTP 通信、远程 MCP 服务、生产环境中的高级流式场景 |
优点是兼容 HTTP,同时比普通 HTTP 更适合流式交互。缺点是需要服务端和客户端都支持这种传输方式,配置会比 Stdio 复杂。
可以理解为:
它是更适合 MCP 场景的现代 HTTP 流式传输。
适用场景:需要双向流式通信的 HTTP 场景
1 |
|
如何选择?
| 场景 | 推荐方式 |
|---|---|
| 单元测试、快速验证 | Memory |
| 本地运行 MCP 工具 | Stdio |
| 本地文件系统、命令行工具 | Stdio |
| 远程部署 MCP Server | HTTP 或 StreamableHTTP |
| 需要实时返回进度 | SSE 或 StreamableHTTP |
| 需要双向流式通信 | StreamableHTTP |
| 生产环境服务化部署 | StreamableHTTP / HTTP |
| 简单实验代码 | Stdio |
A2A
当一个网络中存在大量功能各异的智能体(例如,自然语言处理、图像识别、数据分析等)时,系统会面临一系列挑战:
- 服务发现:当新任务到达时,如何快速找到能够处理该任务的智能体?
- 智能路由:如果多个智能体都能处理同一任务,如何选择最合适的一个(如根据负载、成本等)并向其分派任务?
- 动态扩展:如何让新加入网络的智能体被其他成员发现和调用?
ANP 的设计目标就是提供一套标准化的机制,来解决上述的服务发现、路由选择和网络扩展性问题。
为实现其设计目标,ANP 定义了以下几个核心概念
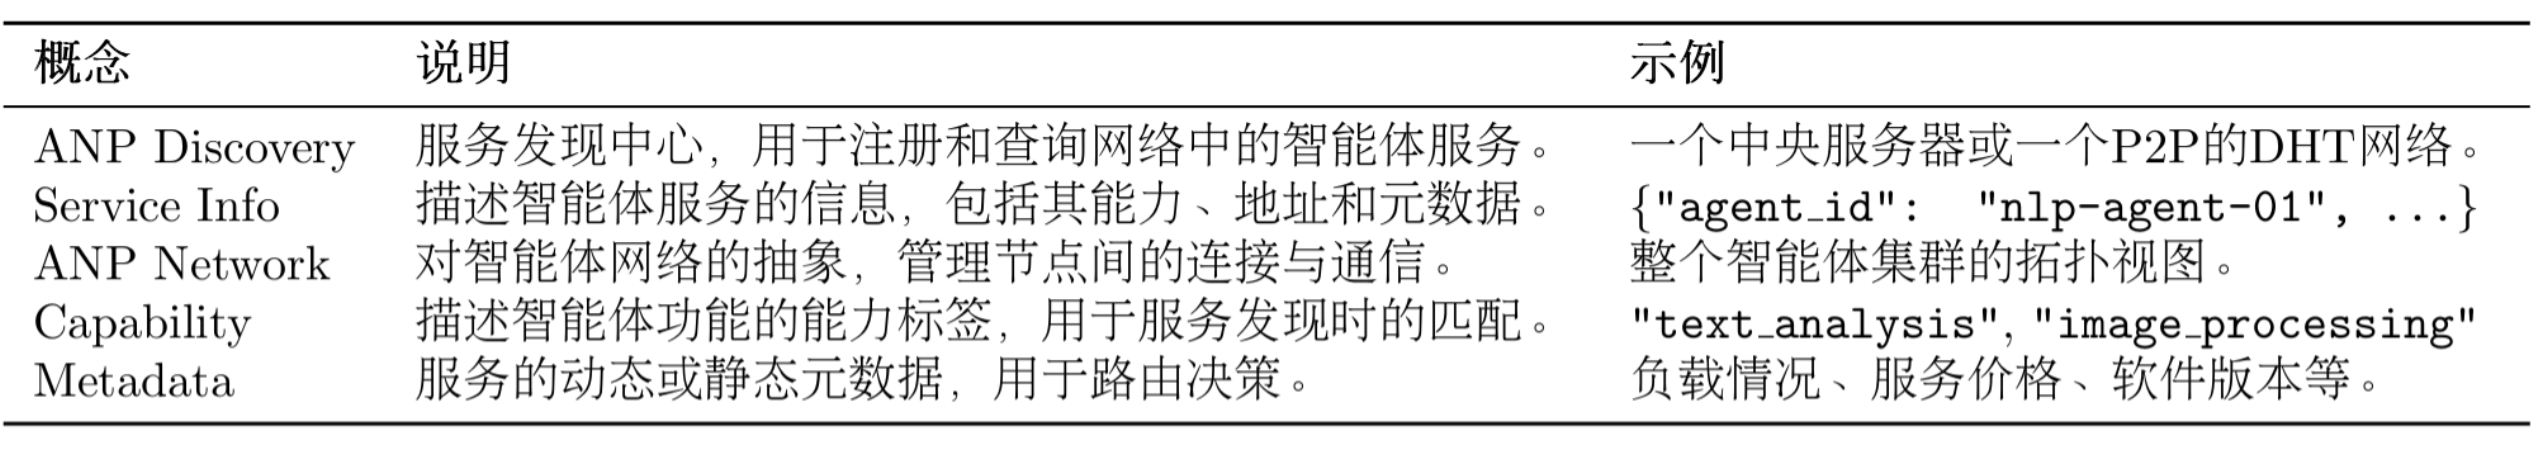
为实现对协作过程的管理,A2A 为任务定义了标准化的生命周期,包括创建、协商、代理、执行中、完成、失败等状态
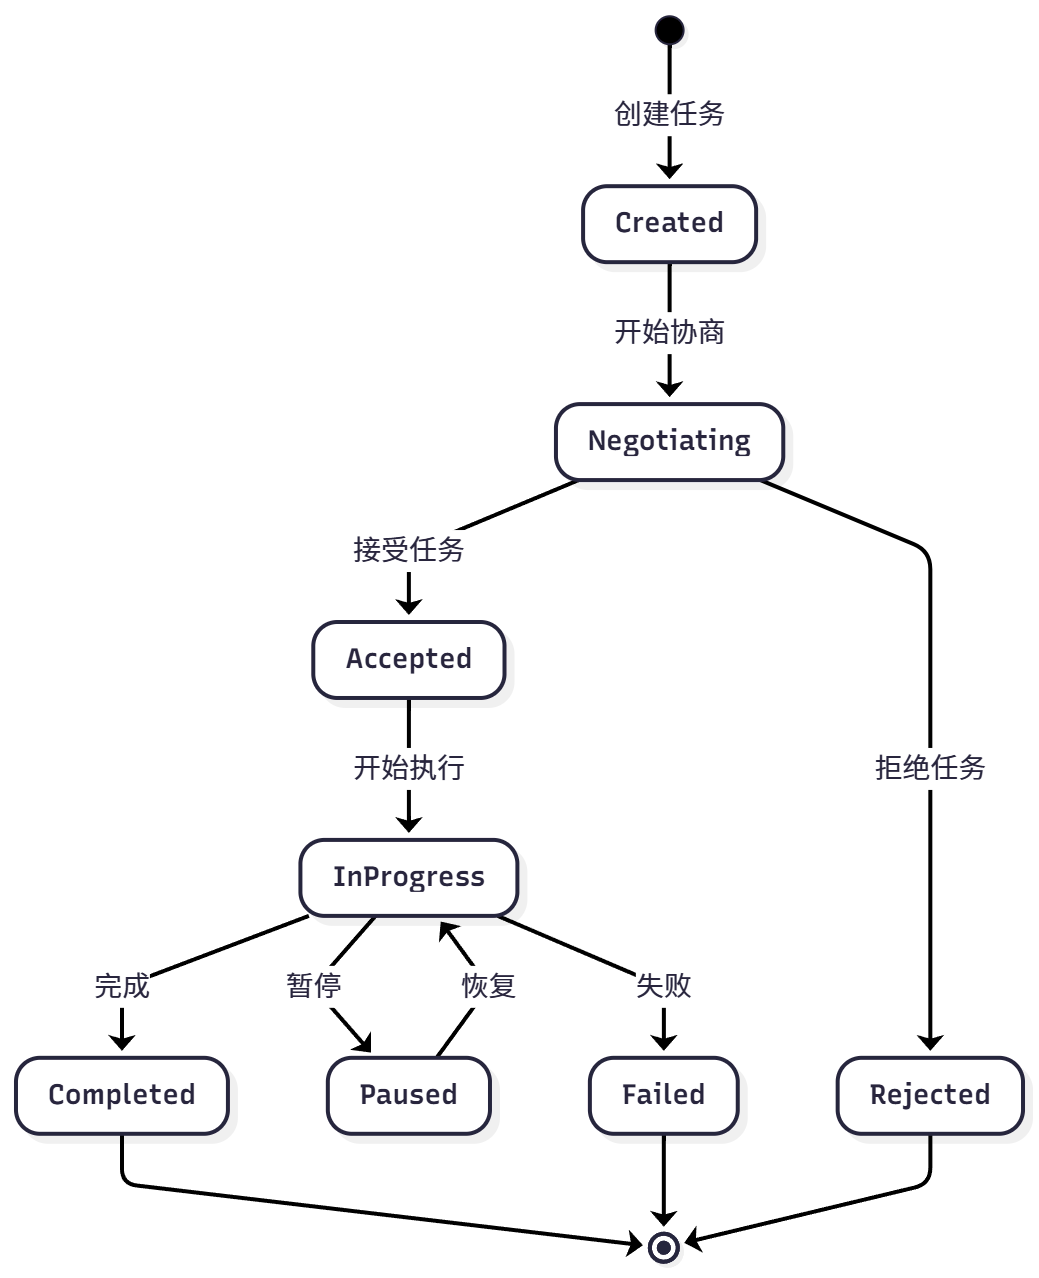
该机制使智能体可以进行任务协商、进度跟踪和异常处理。
A2A 请求生命周期是一个序列,详细说明了请求遵循的四个主要步骤:代理发现、身份验证、发送消息 API 和发送消息流 API。下图 10.8 借鉴了官网的流程图,用来展示了操作流程,说明了客户端、A2A 服务器和身份验证服务器之间的交互。
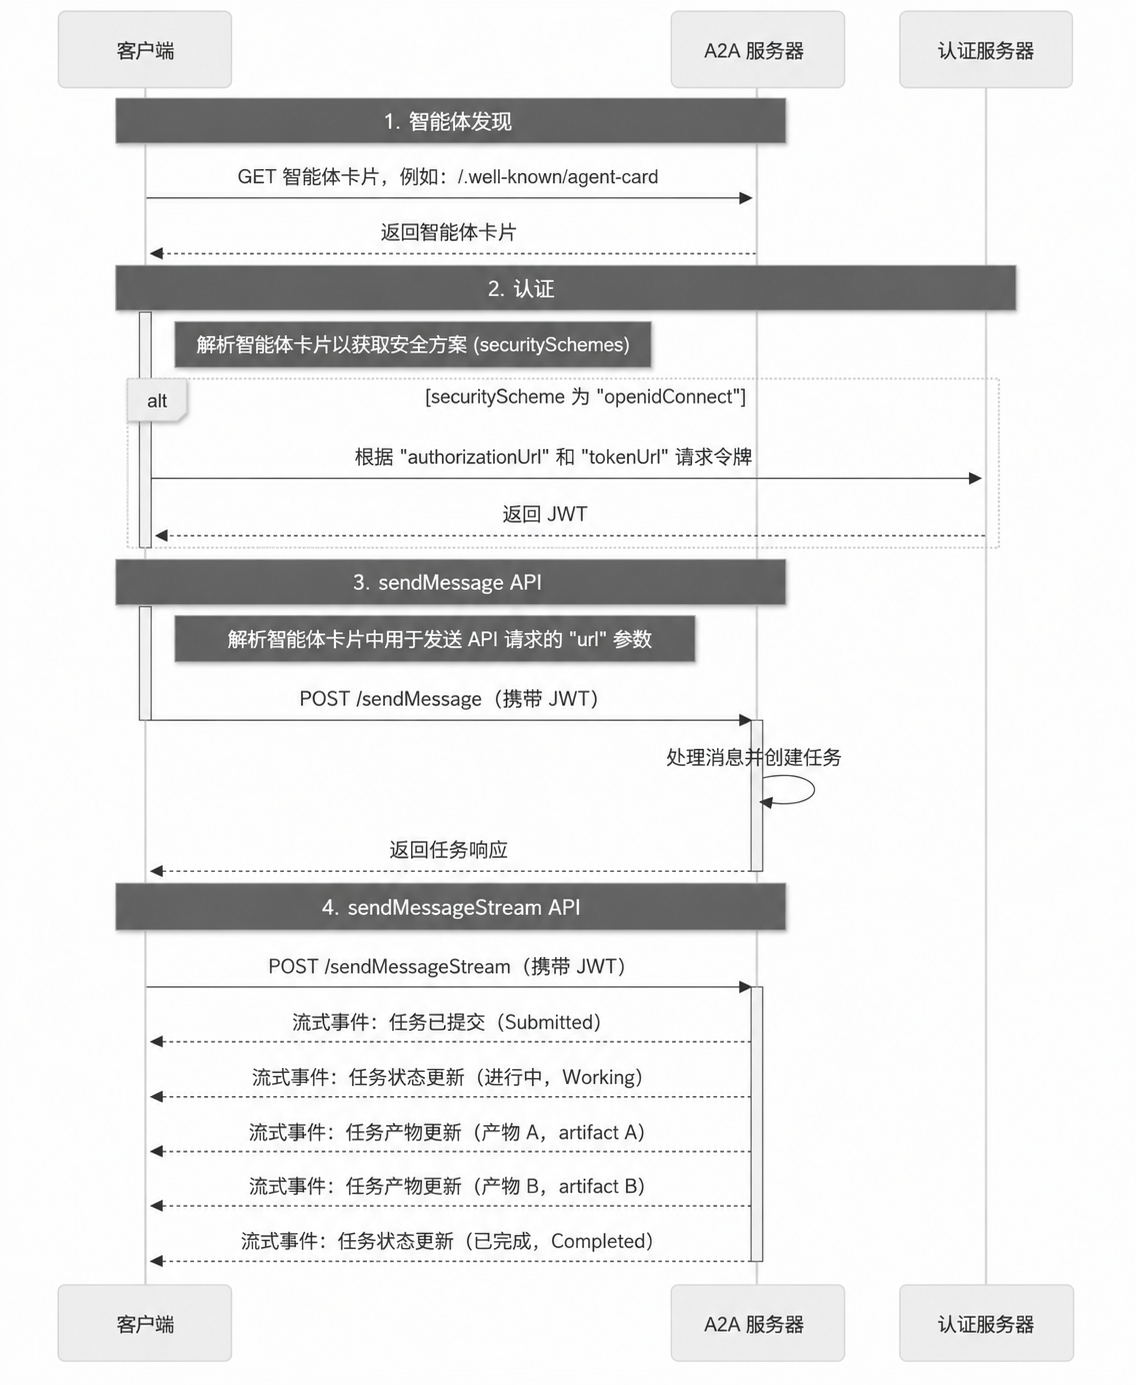
A2A架构
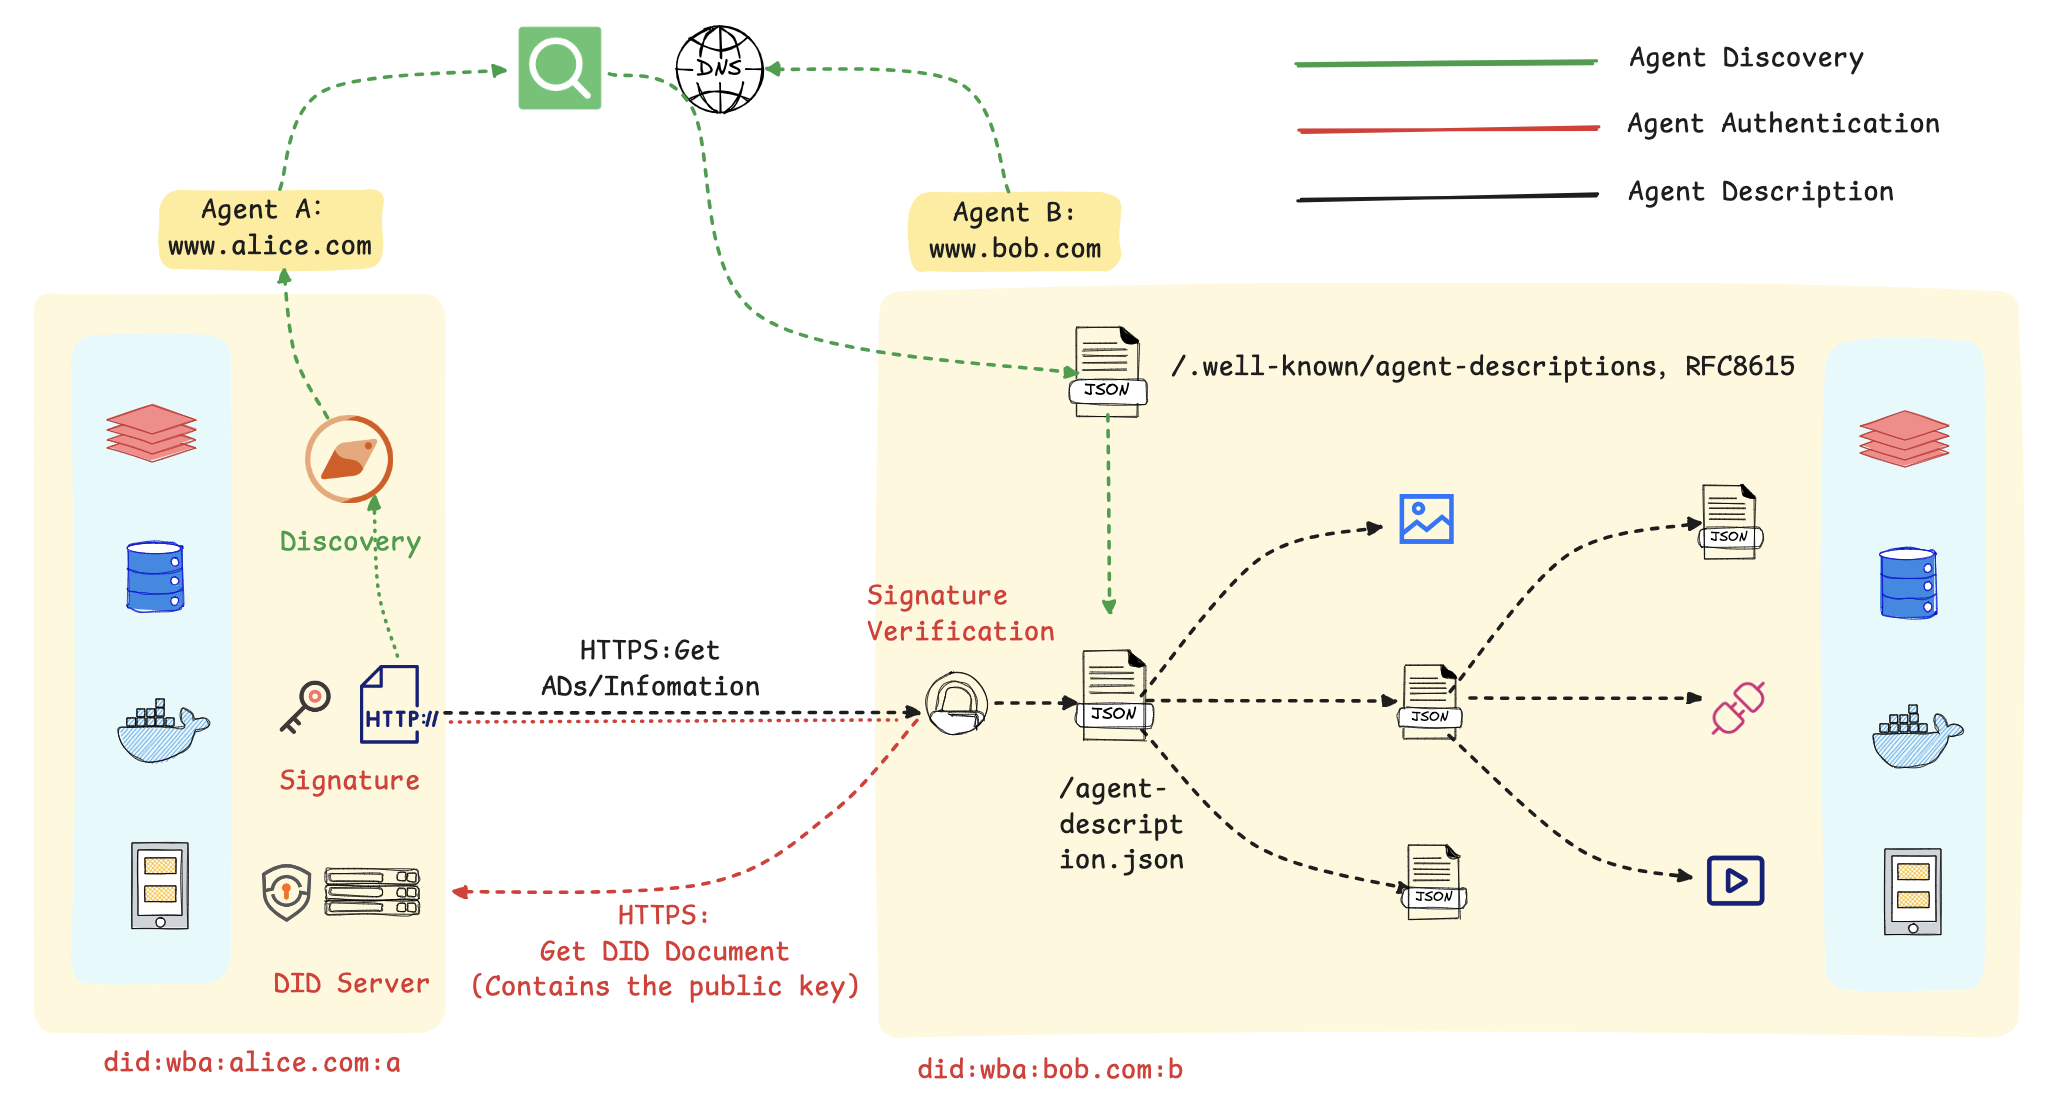
在这个流程图里,主要包括以下几个步骤:
**1. 服务的发现与匹配:**首先,智能体 A 通过一个公开的发现服务,基于语义或功能描述进行查询,以定位到符合其任务需求的智能体 B。该发现服务通过预先爬取各智能体对外暴露的标准端点(.well-known/agent-descriptions)来建立索引,从而实现服务需求方与提供方的动态匹配。
**2. 基于 DID 的身份验证:**在交互开始时,智能体 A 使用其私钥对包含自身 DID 的请求进行签名。智能体 B 收到后,通过解析该 DID 获取对应的公钥,并以此验证签名的真实性与请求的完整性,从而建立起双方的可信通信。
**3. 标准化的服务执行:**身份验证通过后,智能体 B 响应请求,双方依据预定义的标准接口和数据格式进行数据交换或服务调用(如预订、查询等)。标准化的交互流程是实现跨平台、跨系统互操作性的基础。
总而言之,该机制的核心是利用 DID 构建了一个去中心化的信任根基,并借助标准化的描述协议实现了服务的动态发现。这套方法使得智能体能够在无需中央协调的前提下,安全、高效地在互联网上形成协作网络。
Agentic-RL
强化学习(Reinforcement Learning, RL)是一种专注于解决序贯决策问题的学习范式,它通过智能体与环境的直接交互,在”试错”中学习如何最大化长期收益。
现在,让我们将这个框架应用到 LLM 智能体上。考虑一个数学问题求解智能体,它需要回答这样的问题:
1 | 问题: Janet's ducks lay 16 eggs per day. She eats three for breakfast |
这个问题需要多步推理:首先计算 Janet 每天剩余的鸡蛋数量(16 - 3 - 4 = 9),然后计算她的收入(9 × 2 = 18)。我们可以将这个任务映射到强化学习框架:
- 智能体:基于 LLM 的推理系统
- 环境:数学问题和验证系统
- 状态:当前的问题描述和已有的推理步骤
- 行动:生成下一步推理或最终答案
- 奖励:答案是否正确(正确+1,错误 0)
传统的监督学习方法存在三个核心局限:一是数据质量完全决定训练质量,模型只能模仿训练数据,难以超越;二是缺乏探索能力,只能被动学习人类提供的路径;三是难以优化长期目标,无法精确优化多步推理的中间过程。
强化学习提供了新的可能性。通过让智能体自主生成多个候选答案并根据正确性获得奖励,它可以学习哪些推理路径更优、哪些步骤是关键,甚至发现比人类标注更好的解题方法[8]。这就是 Agentic RL 的核心思想:将 LLM 作为可学习策略,嵌入智能体的感知-决策-执行循环,通过强化学习优化多步任务表现。
LLM训练概况
一个强大的 LLM(如 GPT、Claude、Qwen)的诞生,通常要经历两个主要阶段:预训练(Pretraining)和后训练(Post-training)。如图 11.1 所示,这两个阶段构成了 LLM 从”语言模型”到”对话助手”的完整演化路径。
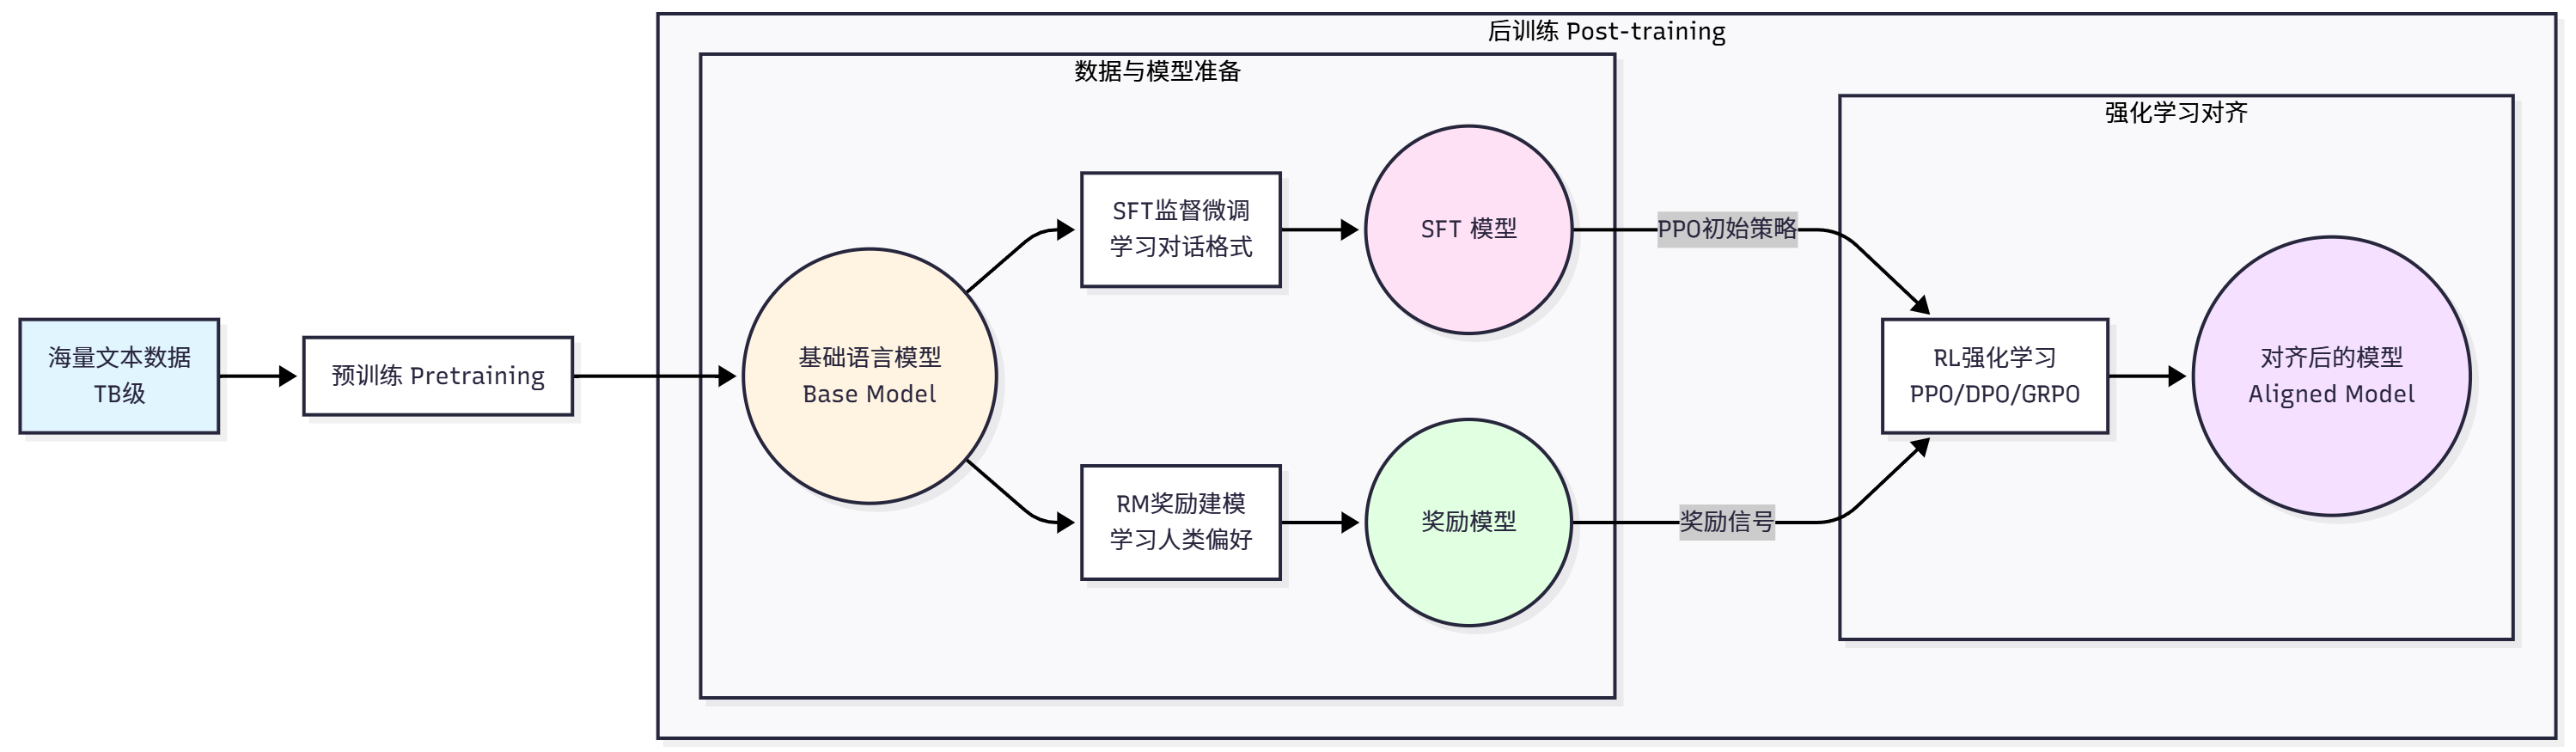
预训练阶段是 LLM 训练的第一阶段,目标是让模型学习语言的基本规律和世界知识。这个阶段使用海量的文本数据(通常是数 TB 级别),通过自监督学习的方式训练模型:训练信号来自文本本身,例如根据上文预测下一个词。最常见的预训练任务是因果语言建模(Causal Language Modeling),也称为下一个词预测(Next Token Prediction)。
给定一个文本序列 x1,x2,…,xtx1,x2,…,x**t,模型需要预测下一个词 xt+1x**t+1:
Lpretrain=−∑t=1TlogP(xt∣x1,x2,…,xt−1;θ)Lpretrain=−t=1∑TlogP(x**t∣x1,x2,…,x**t−1;θ)
其中 θθ 是模型参数,P(xt∣x1,…,xt−1;θ)P(x**t∣x1,…,x**t−1;θ) 是模型预测的下一个词的概率分布,目标是最小化负对数似然,即最大化预测正确词的概率。例如,给定文本”The cat sat on the”,模型需要预测下一个词最可能是”mat”。通过在海量文本上进行这样的训练,模型逐渐学会语法规则(什么样的词序是合法的)、语义知识(词与词之间的关系)、世界知识(关于世界的事实性信息)以及基础的推理能力。
预训练阶段的特点是数据量巨大、计算成本高,学到的是通用的语言理解和生成能力,训练过程通常采用从未标注文本中自动构造监督信号的自监督目标。
后训练阶段则是要解决预训练模型的不足。预训练后的模型虽然具备了强大的语言能力,但它只是一个”预测下一个词”的模型,并不知道如何遵循人类的指令、生成有帮助无害诚实的回答、拒绝不当的请求,以及以对话的方式与人交互。后训练阶段就是要解决这些问题,让模型对齐人类的偏好和价值观。
后训练通常包含三个步骤。第一步是监督微调(SFT)[15],目标是让模型学会遵循指令和对话格式。训练数据是(prompt, completion)对,训练目标与预训练类似,仍然是最大化正确输出的概率:
LSFT=−∑i=1NlogP(yi∣xi;θ)LSFT=−i=1∑NlogP(y**i∣x**i;θ)
其中 xix**i 是输入提示(prompt),yiy**i 是期望的输出,NN 是训练样本数量。SFT 的特点是数据量较小、需要人工标注、快速见效、主要学习任务格式和基本能力。
第二步是奖励建模(RM)。SFT 后的模型虽然能遵循指令,但生成的回答质量参差不齐。我们需要一种方式来评估回答的质量,这就是奖励模型的作用[13,14]。奖励模型的训练数据是偏好对比数据,包含同一个问题的两个回答,一个更好(chosen),一个更差(rejected)。奖励模型的训练目标是学习人类的偏好:
LRM=−E(x,yw,yl)[logσ(rϕ(x,yw)−rϕ(x,yl))]LRM=−E(x,y**w,y**l)[logσ(r**ϕ(x,y**w)−r**ϕ(x,y**l))]
其中 rϕ(x,y)r**ϕ(x,y) 是奖励模型,输入是(提示,回答)对,输出是质量分数;ywy**w 是更好的回答(chosen),yly**l 是更差的回答(rejected),σσ 是 sigmoid 函数,目标是让奖励模型给更好的回答更高的分数。
第三步是强化学习微调。有了奖励模型后,我们就可以用强化学习来优化语言模型,让它生成更高质量的回答。最经典的算法是 PPO(Proximal Policy Optimization)[1],训练目标是:
JPPO=Ex,y∼πθ[rϕ(x,y)]−β⋅DKL(πθ∣∣πref)JPPO=Ex,y∼π**θ[r**ϕ(x,y)]−β⋅DKL(π**θ∣∣πref)
其中 πθπ**θ 是当前策略,即语言模型,πrefπref 是参考策略,这个场景下可以是 SFT 模型,rϕ(x,y)r**ϕ(x,y) 是奖励模型的评分,DKLDKL 是 KL 散度,目的是为了防止模型偏离太远,ββ 是平衡系数。这个目标函数的含义是:最大化奖励,同时不要偏离原始模型太远。
传统的 RLHF(Reinforcement Learning from Human Feedback)[5]需要大量人工标注偏好数据,成本高昂。为了降低成本,研究者提出了 RLAIF(Reinforcement Learning from AI Feedback)[7],用强大的 AI 模型(如 GPT-4)来替代人类标注员。RLAIF 的工作流程是:用 SFT 模型生成多个候选回答,用强大的 AI 模型对回答进行评分和排序,用 AI 的评分训练奖励模型,用奖励模型进行强化学习。实验表明,RLAIF 的效果接近甚至超过 RLHF,同时成本大幅降低[11]。
Agentic RL核心理念
Agentic RL则是一种新的范式,它将 LLM 视为一个可学习的策略,嵌入在一个顺序决策循环中。在这个框架下,智能体需要在动态环境中与外部世界交互,执行多步行动来完成复杂任务,获得中间反馈来指导后续决策,优化长期累积奖励而非单步奖励。
让我们通过一个具体例子来理解这个区别。在 PBRFT 场景中,用户问”请解释什么是强化学习”,模型生成完整回答,然后根据回答质量直接给分。而在 Agentic RL 场景中,用户请求”帮我分析这个 GitHub 仓库的代码质量”,智能体需要经历多个步骤:首先调用 GitHub API 获取仓库信息,成功获得仓库结构和文件列表,得到+0.1 的奖励;然后读取主要代码文件,成功获得代码内容,得到+0.1 的奖励;接着分析代码质量合理,得到+0.2 的奖励;最后生成分析报告质量高,得到+0.6 的奖励。总奖励是所有步骤的累积:1.0。
可以看到,Agentic RL 的关键特征是多步交互、每一步的行动都会改变环境状态、每一步都可以获得反馈、优化整个任务的完成质量。
Agentic RL 的目标是赋予 LLM 智能体六大核心能力
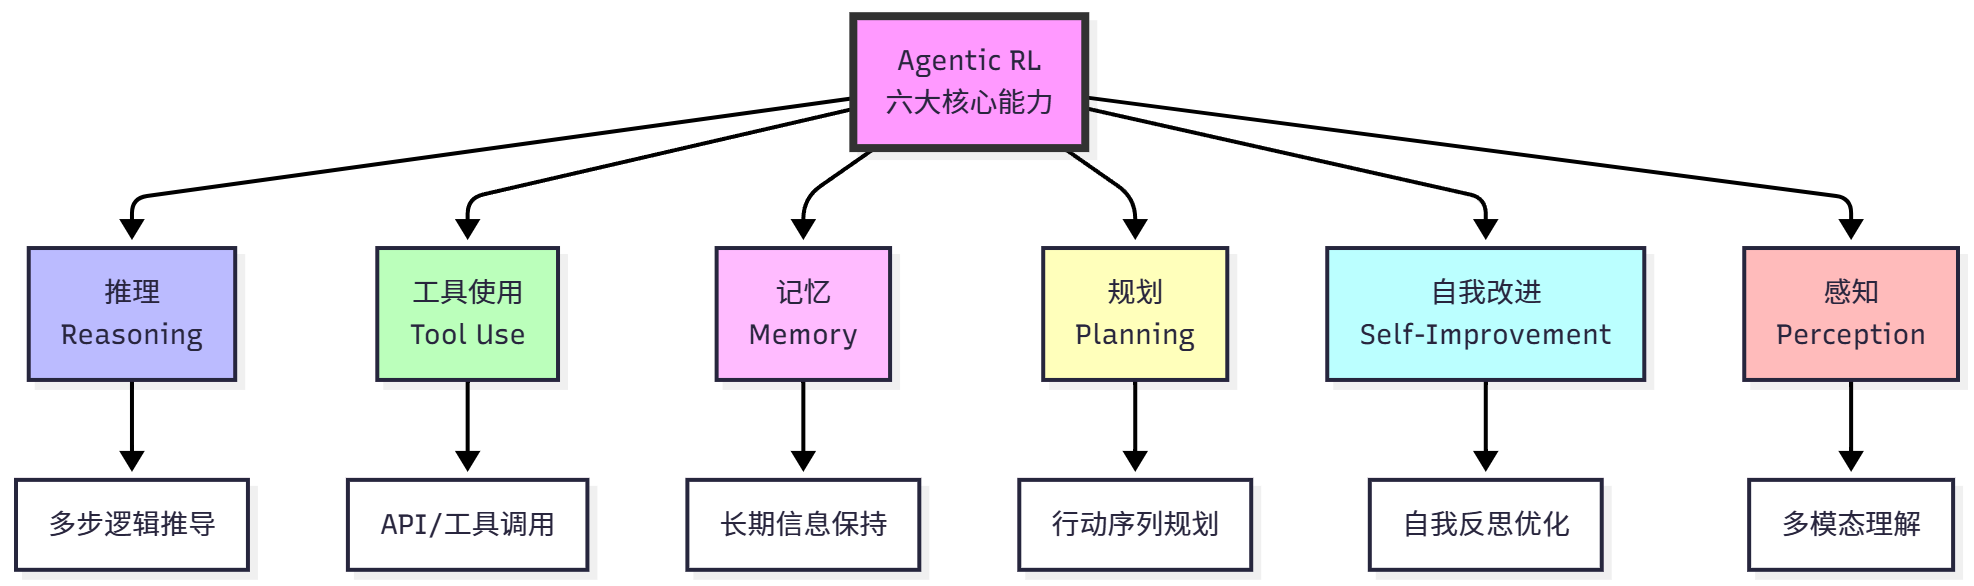
推理(Reasoning)*是指从给定信息中逻辑地得出结论的过程,是智能体的核心能力。传统的 CoT 提示方法依赖少样本示例,泛化能力有限;SFT 只能模仿训练数据中的推理模式,难以创新。强化学习的优势在于通过试错学习有效的推理策略,发现训练数据中没有的推理路径,学会何时需要深度思考、何时可以快速回答。推理任务可以建模为序列决策问题,给定问题 qq*,智能体需要生成推理链 c=(c1,c2,…,cn)c=(c1,c2,…,c**n) 和最终答案 aa*。奖励函数通常设计为 r(q,c,a)=1r(q,c,a)=1 if a=a∗a=a∗ else 00,训练目标是 maxθEq,(c,a)∼πθ[r(q,c,a)]maxθE*q,(c,a)∼π**θ[r(q,c,a)]。通过这种方式,模型学会生成高质量的推理链,而不仅仅是记忆答案。
工具使用(Tool Use)*是指智能体调用外部工具来完成任务的能力。在工具使用任务中,行动空间扩展为 at∈{atthink,attool}*a**t∈{a**tthink,*attool},其中 atthinka*tthink 是生成思考过程,attool=(tool_name,arguments)a**ttool=(tool_name,arguments) 是调用工具。强化学习让智能体学会何时需要使用工具、选择哪个工具、如何组合多个工具。例如,在解决数学问题时,智能体需要学会何时使用计算器、何时使用代码解释器、何时直接推理。
**记忆(Memory)**是指智能体保持和重用过去信息的能力,对于长期任务至关重要。LLM 的上下文窗口有限,静态检索策略(如 RAG)无法针对任务优化。强化学习让智能体学会记忆管理策略:决定哪些信息值得记住、何时更新记忆、何时删除过时信息。这类似于人类的工作记忆,我们会主动管理大脑中的信息,保留重要的、遗忘无关的。
**规划(Planning)**是指制定行动序列以达成目标的能力。传统的 CoT 是线性思考,无法回溯;提示工程使用静态规划模板,难以适应新情况。强化学习让智能体学会动态规划:通过试错发现有效的行动序列,学会权衡短期和长期收益。例如,在多步任务中,智能体可能需要先执行一些看似”绕路”的步骤,例如收集信息,才能最终完成任务。
**自我改进(Self-Improvement)**是指智能体回顾自身输出、纠正错误并优化策略的能力。强化学习让智能体学会自我反思:识别自己的错误、分析失败原因、调整策略。这种能力使得智能体能够在没有人工干预的情况下持续改进,类似于人类的”从错误中学习”。
**感知(Perception)**是指理解多模态信息的能力。例如,强化学习可以提升视觉推理能力,让模型学会使用视觉工具,学会视觉规划。这使得智能体不仅能理解文本,还能理解和操作视觉世界。
 wechat
 alipay